클로드 Opus 5가 나오면서 가장 많이 보이는 질문이 두 가지다. “Opus 4.8이랑 뭐가 다른가?”와 “Fable 5가 있는데 굳이 Opus 5를 써야 하나?”다. 결론부터 말하면, Opus 5는 Anthropic의 Opus 계열 최상위 모델이면서 Fable 5의 절반 가격에 근접한 성능을 낸다. 다만 모든 벤치마크 1위는 아니고, 실사용 체감도 사람마다 갈린다.
Opus 5란
Anthropic이 2026년 7월 24일 공개한 모델이다. 공식 포지셔닝은 “복잡한 에이전트 코딩과 전문 지식 업무를 위한 최상위 Opus 모델”이다. Anthropic은 이걸 단순 업그레이드가 아니라 “step-change improvement”라고 표현한다.
주의할 점이 있다. Opus 5는 Anthropic 전체에서 가장 강한 모델이 아니다. Fable 5라는 상위 모델이 따로 있고, Opus 5는 그 frontier intelligence에 근접하면서 가격은 절반이라는 위치다. 즉 성능과 비용 사이의 균형을 잡은 고성능 실사용 모델이라고 보는 게 맞다.
이전 Opus 대비 무엇이 달라졌나
Opus 4.8에서 5로 넘어오면서 컨텍스트 길이(1M 토큰)나 가격은 바뀌지 않았다. 달라진 건 같은 조건에서 작업을 끝까지 해내는 능력이다.
Anthropic 개발자 문서가 꼽는 세 가지 핵심 향상 영역은 이렇다.
- 심층 추론: 긴 문제 풀이에서 추론을 더 오래 유지
- 에이전트 작업: 다단계 작업, 도구 사용, 자기 검증 능력 대폭 향상
- Test-time compute: effort를 높였을 때 실제 성능 상승폭이 이전보다 큼
특히 행동 변화가 눈에 띈다. Opus 5는 결과를 내놓기 전에 스스로 확인하고, 실패하면 반복 수정해서 완료 상태까지 끌고 가는 행동이 훨씬 강해졌다. Anthropic은 오픈소스 버그 평가에서 표면 증상만 고친 경쟁 모델과 달리, Opus 5가 근본 원인을 찾고 커뮤니티 패치가 놓친 edge case까지 수정한 사례를 제시한다.
클로드 Opus 5 가격
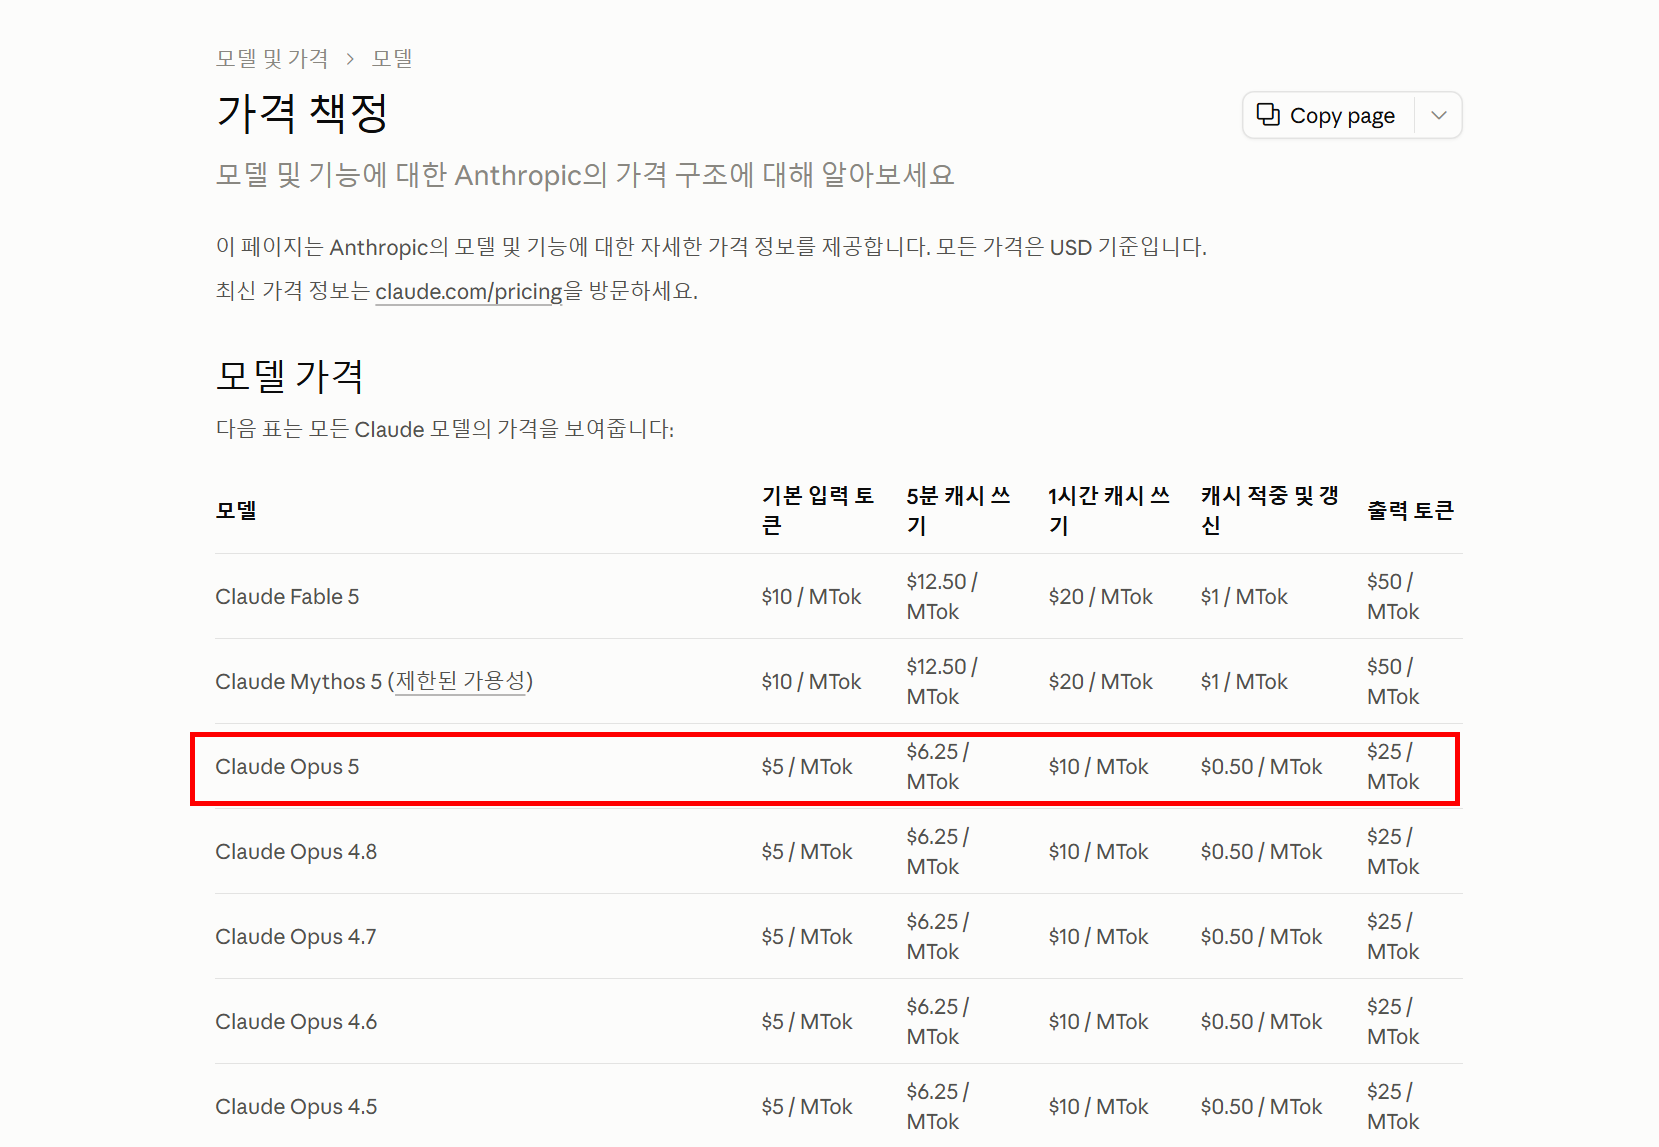
API 가격은 Opus 4.8과 동일하다.
| 항목 | Opus 5 | Fable 5 |
|---|---|---|
| 기본 입력 토큰 | $5 / MTok | $10 / MTok |
| 5분 캐시 쓰기 | $6.25 / MTok | $12.50 / MTok |
| 1시간 캐시 쓰기 | $10 / MTok | $20 / MTok |
| 캐시 적중 | $0.50 / MTok | $1 / MTok |
| 출력 토큰 | $25 / MTok | $50 / MTok |
Fable 5 대비 입력·출력 모두 정확히 절반이다.
토큰 사용량과 속도 제한
이 부분은 많이 헷갈리는 영역이다. API와 Claude 구독(Pro/Max/Team)의 한도 체계가 완전히 다르기 때문이다.
API 속도 제한
Opus 5는 Opus 4.x와 별도 rate-limit bucket을 갖는다. 이전 Opus 사용량 때문에 Opus 5 한도가 차감되지 않는다.
| API 티어 | RPM | 입력 토큰/분 | 출력 토큰/분 | 월 지출 상한 |
|---|---|---|---|---|
| Start | 1,000 | 2,000,000 | 400,000 | $500 |
| Build | 5,000 | 5,000,000 | 1,000,000 | $1,000 |
| Scale | 10,000 | 10,000,000 | 2,000,000 | $200,000 |
“하루 최대 N토큰”이라는 일일 토큰 쿼터는 없다. 분당 처리량 제한 + 월간 지출 상한, 이 두 축으로 제한된다. Rate limit은 token bucket 방식이라 매분 정각에 리셋되는 것도 아니다.
캐시 적중된 토큰은 ITPM에서 제외되므로, 캐싱률이 높으면 Start 티어의 2M ITPM에서도 실질적으로 훨씬 많은 입력을 처리할 수 있다.
Claude Pro / Max 사용량
Claude 앱 구독은 API처럼 토큰 수를 공개하지 않는다. “Pro는 하루 10만 토큰” 같은 수치는 공식 근거가 없다.
구조는 이렇다.
- 5시간 세션 사용량 제한 + 주간 전체 사용량 제한
- Max 5x는 Pro의 5배, Max 20x는 Pro의 20배 (5시간 세션 기준)
- 대화 길이, 첨부 파일, 모델, 도구, effort 수준에 따라 실제 사용 가능량이 달라짐
- 주간 한도는 계정별 고정 요일·시간에 리셋
Team도 별도 체계다. Standard는 Pro의 1.25배, Premium은 6.25배다. 한도는 구성원별 독립 적용이라 한 명이 소진해도 다른 사람에게 영향 없다.
Opus 5 성능: 벤치마크로 보면
공식 비교표에서 특히 눈에 띄는 항목만 추리면 이렇다.
| 평가 | Opus 5 | Opus 4.8 | 변화 |
|---|---|---|---|
| Frontier-Bench (에이전트 코딩) | 43.3% | 21.1% | 약 2배 |
| ARC-AGI-3 (새로운 문제 해결) | 30.2% | 1.5% | +28.7%p |
| OSWorld 2.0 (컴퓨터 사용) | 70.6% | 55.7% | +14.9%p |
| AutomationBench (업무 자동화) | 26.0% | 17.0% | +9.0%p |
| DeepSWE v1.1 (에이전트 코딩) | 68.8% | 59.0% | +9.8%p |
| GDPval-AA v2 (지식 업무) | 1861 Elo | 1593 | +268 Elo |
패턴이 보인다. 짧은 QA보다 실제로 도구를 사용하면서 여러 단계를 끝까지 수행하는 평가에서 상승폭이 크다. Frontier-Bench에서는 성능을 두 배 이상 높이면서 task당 비용은 더 낮았다고 Anthropic이 따로 강조한다.
다만 모든 평가에서 1위는 아니다. DeepSWE는 GPT-5.6 Sol이 72.7%로 앞서고, Humanity’s Last Exam 도구 없는 조건에서는 Fable 5가 56.5%로 Opus 5(56.3%)를 근소하게 이긴다.
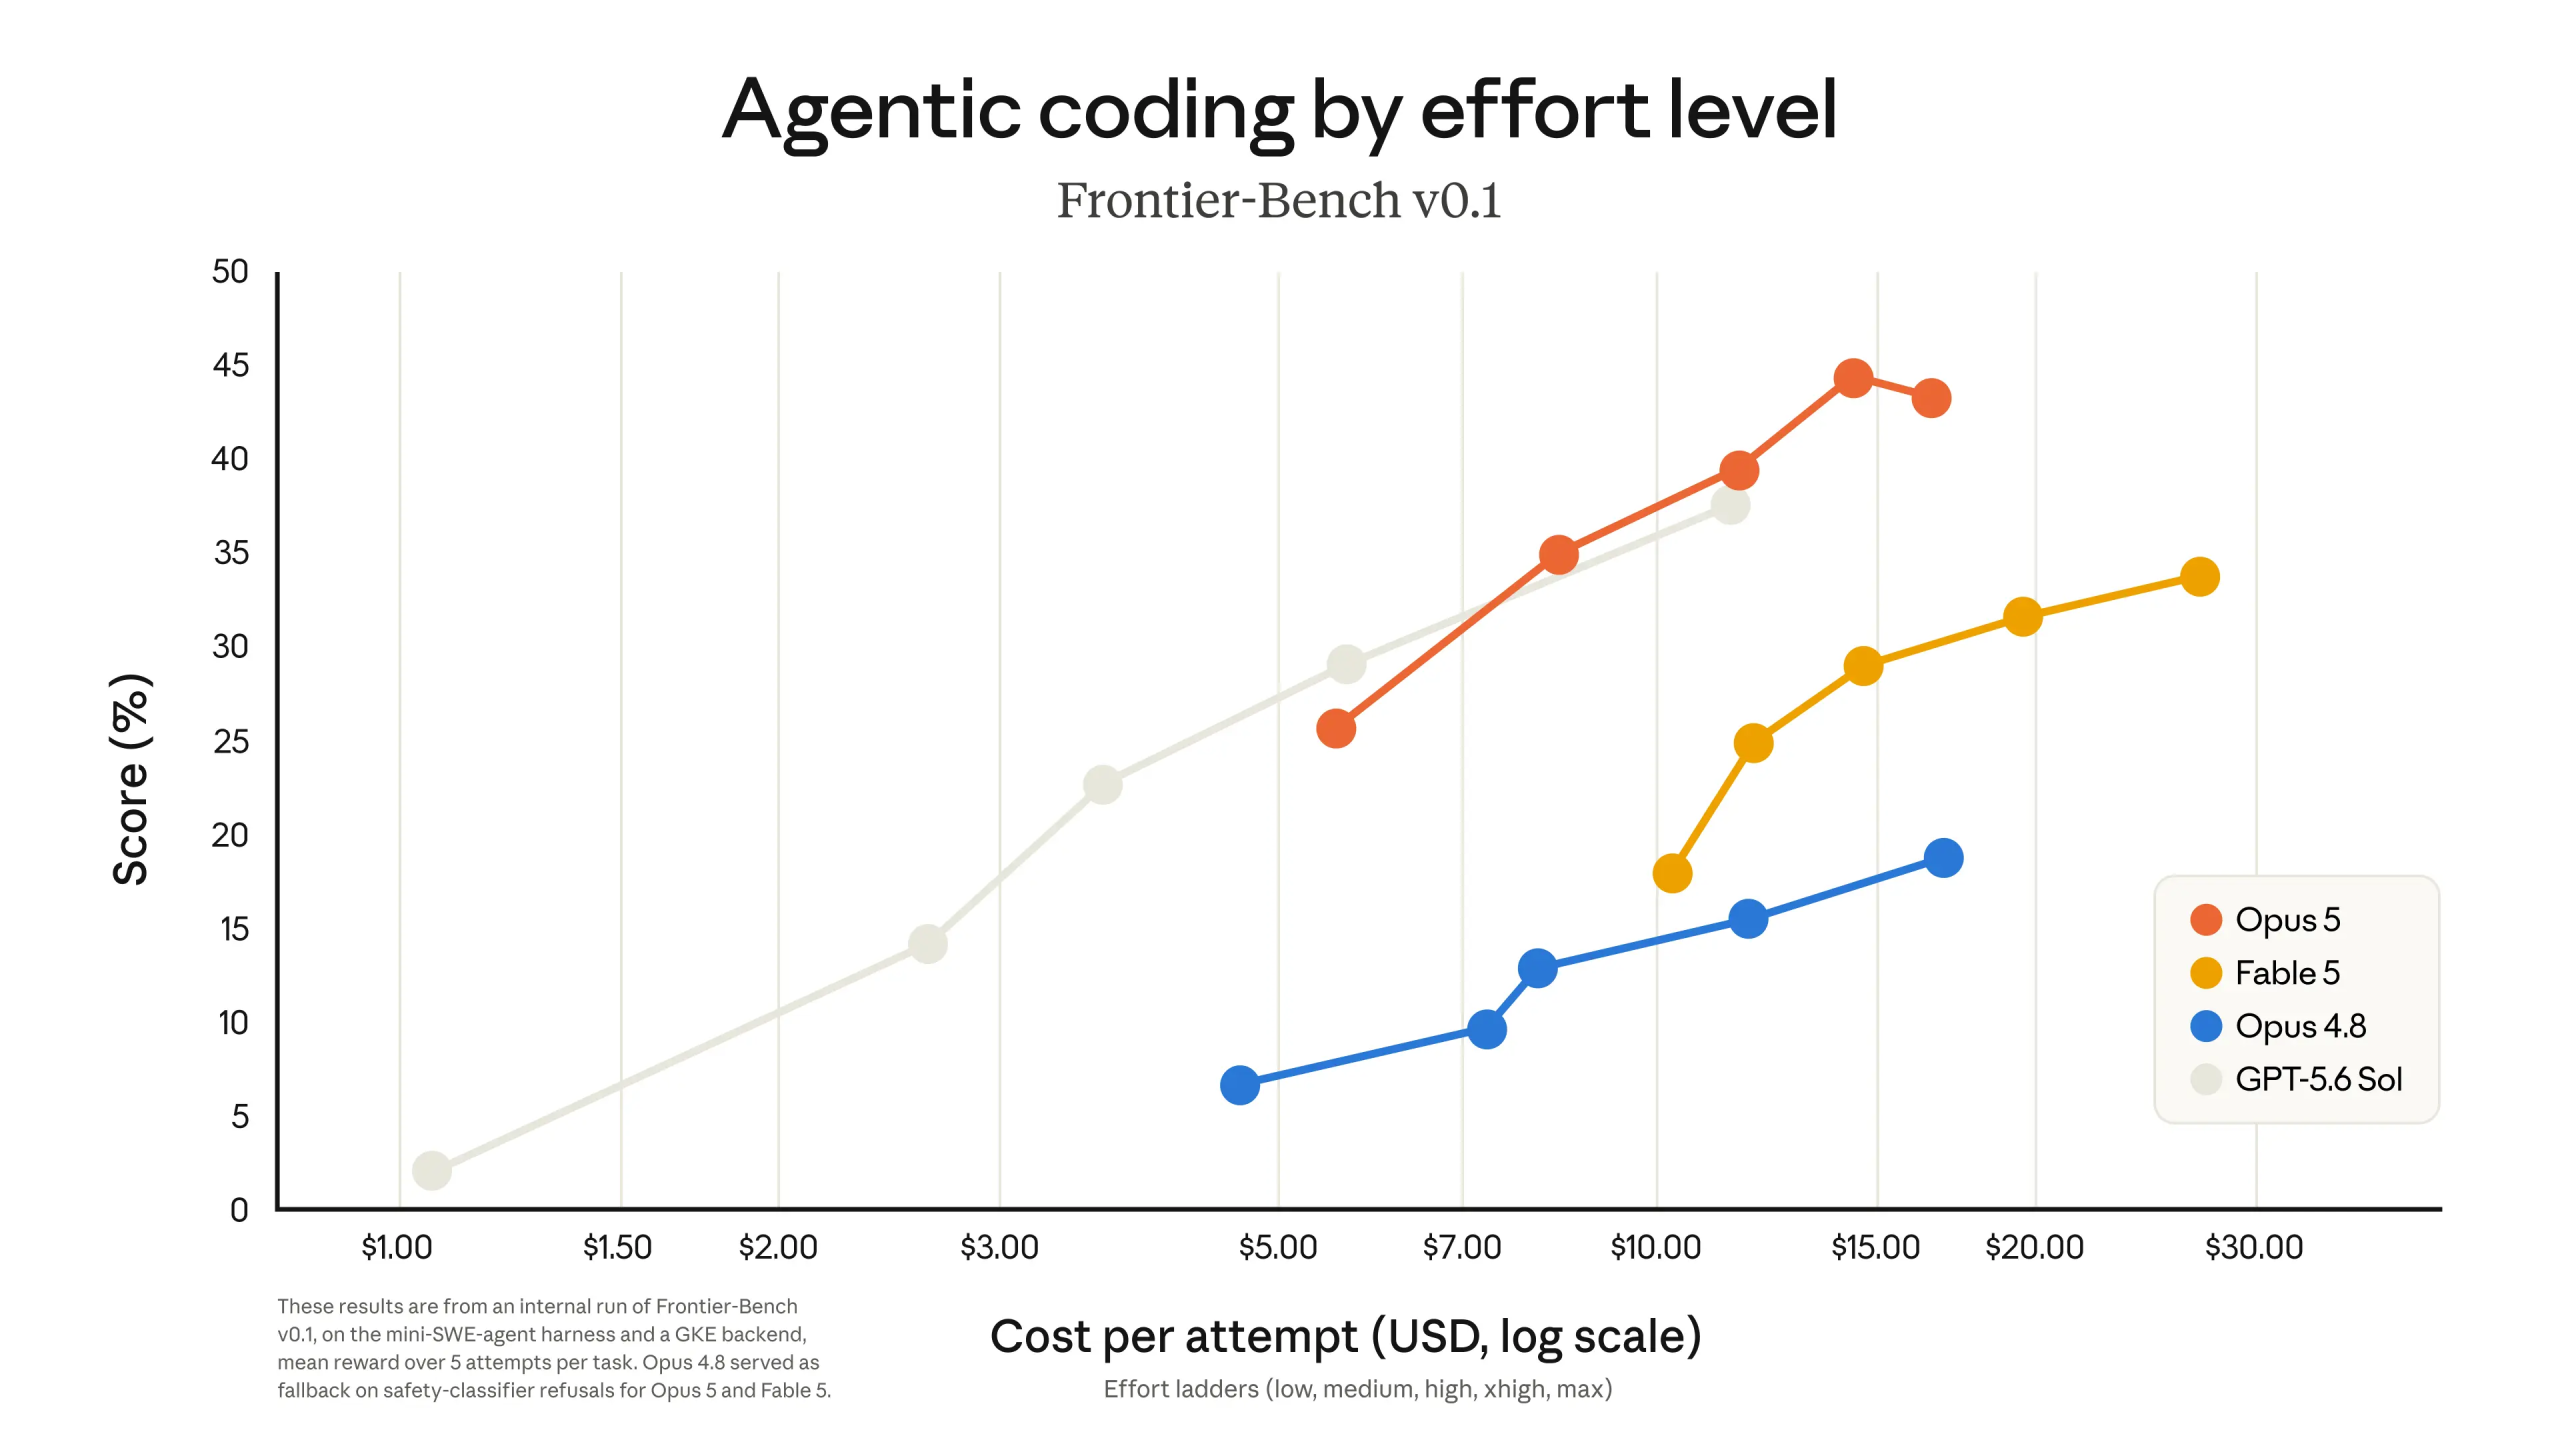
위 차트를 보면 effort 수준별 비용 대비 성능에서 Opus 5(주황)가 같은 비용 구간에서 Fable 5(노랑), Opus 4.8(파랑), GPT-5.6 Sol(회색)을 꾸준히 앞선다.
실제 작업에서의 체감
벤치마크는 높은데 실사용 체감은 다를 수 있다. 실제로 커뮤니티에서는 Opus 5가 기대만큼은 아니라는 의견도 적지 않다. Fable 5는커녕 Opus 4.7이나 4.8 전 버전도 못 이긴다는 반응도 있다.
개인적으로는 잘 쓰고 있지만, 이런 평가 차이가 나는 이유를 짐작하면 이렇다. Opus 5의 강점이 가장 두드러지는 영역이 다단계 에이전트 작업, 장시간 추론, 자기 검증이다. 짧은 한두 턴 대화에서는 4.8과 체감 차이가 크지 않을 수 있다. 벤치마크 상승폭이 큰 항목들이 전부 에이전트·멀티스텝 평가라는 점이 이걸 뒷받침한다.
Fable 5와의 차이
가장 간단하게 정리하면 이렇다.
- 가격: Fable 5의 정확히 절반
- 성능: 대부분의 평가에서 Fable 5에 근접하거나 일부 앞섬
- OSWorld 2.0: Opus 5 70.6% vs Fable 5 66.1%. Opus 5가 Fable 5 최고 성능을 약 1/3 비용으로 넘긴 사례
- 일부 평가에서는 Fable 5가 우위: Legal Agent Benchmark, Humanity’s Last Exam 등
Anthropic 스스로가 Opus 5를 “Fable 5의 frontier intelligence에 근접하면서 가격은 절반”이라고 포지셔닝한다. 비용 효율을 따지면 Opus 5가 유리한 경우가 많다.
Claude Code에서 Opus 5 활용
Claude Code CLI에서 Opus 5를 모델로 지정해 사용할 수 있다. 에이전트 코딩 작업이 많다면 Opus 5의 강점이 가장 잘 드러나는 환경이기도 하다. 실제로 Claude Code를 쓸 때 웬만하면 Opus 5를 기본으로 쓰고 있다.
Frontier-Bench 차트에서도 확인되듯, 에이전트 코딩에서 effort를 높일수록 Opus 5의 성능 곡선이 다른 모델보다 가파르게 올라간다. Claude Code처럼 여러 파일을 탐색하고, 수정하고, 테스트까지 반복하는 환경이라면 이 차이가 체감된다.
어떤 사용자에게 맞는가
Opus 5가 적합한 경우
- 에이전트 코딩, 대규모 리팩터링, 멀티파일 디버깅이 주 작업
- Claude Code CLI를 자주 사용
- Fable 5 수준 성능이 필요하지만 비용을 절반으로 줄이고 싶을 때
- 장시간 다단계 작업에서 모델이 끝까지 따라와야 할 때
굳이 Opus 5가 아니어도 되는 경우
- 짧은 대화 위주라면 Opus 4.8과 체감 차이가 크지 않을 수 있다
- 법률, 일부 전문 영역은 Fable 5가 여전히 앞서는 평가가 있다
- 비용이 최우선이라면 Sonnet 계열이 훨씬 저렴하다
가격 대비 결론
Opus 5의 핵심은 “같은 가격에서 더 많은 작업을 완료할 수 있게 됐다”는 것이다. 가격 변동 없이 Opus 4.8 대비 에이전트 코딩 성능을 두 배로 올렸고, Fable 5의 절반 가격에 대부분의 평가에서 근접한 결과를 낸다.
다만 벤치마크 숫자가 곧 체감은 아니다. 커뮤니티 반응이 갈리는 것처럼, 짧은 대화에서는 이전 Opus와 차이를 못 느낄 수 있다. Opus 5의 진가는 모델이 여러 단계를 스스로 판단하고 끝까지 수행해야 하는 작업에서 나온다. 자신의 주 사용 패턴이 그쪽이라면 올릴 가치가 있고, 아니라면 급하게 바꿀 이유는 없다.