그록 4.6은 2026년 8월 12일에 공개된 xAI의 최신 프론티어 모델입니다. 4.5가 나온 지 한 달도 안 돼서 후속 버전이 나왔는데, 실제로 뭐가 좋아졌는지 궁금한 분이 많을 겁니다. 스펙 시트만 봐서는 감이 안 오는 부분을 벤치마크, 가격, 실제 사용 경험까지 묶어서 정리합니다.
4.5 대비 핵심 변화
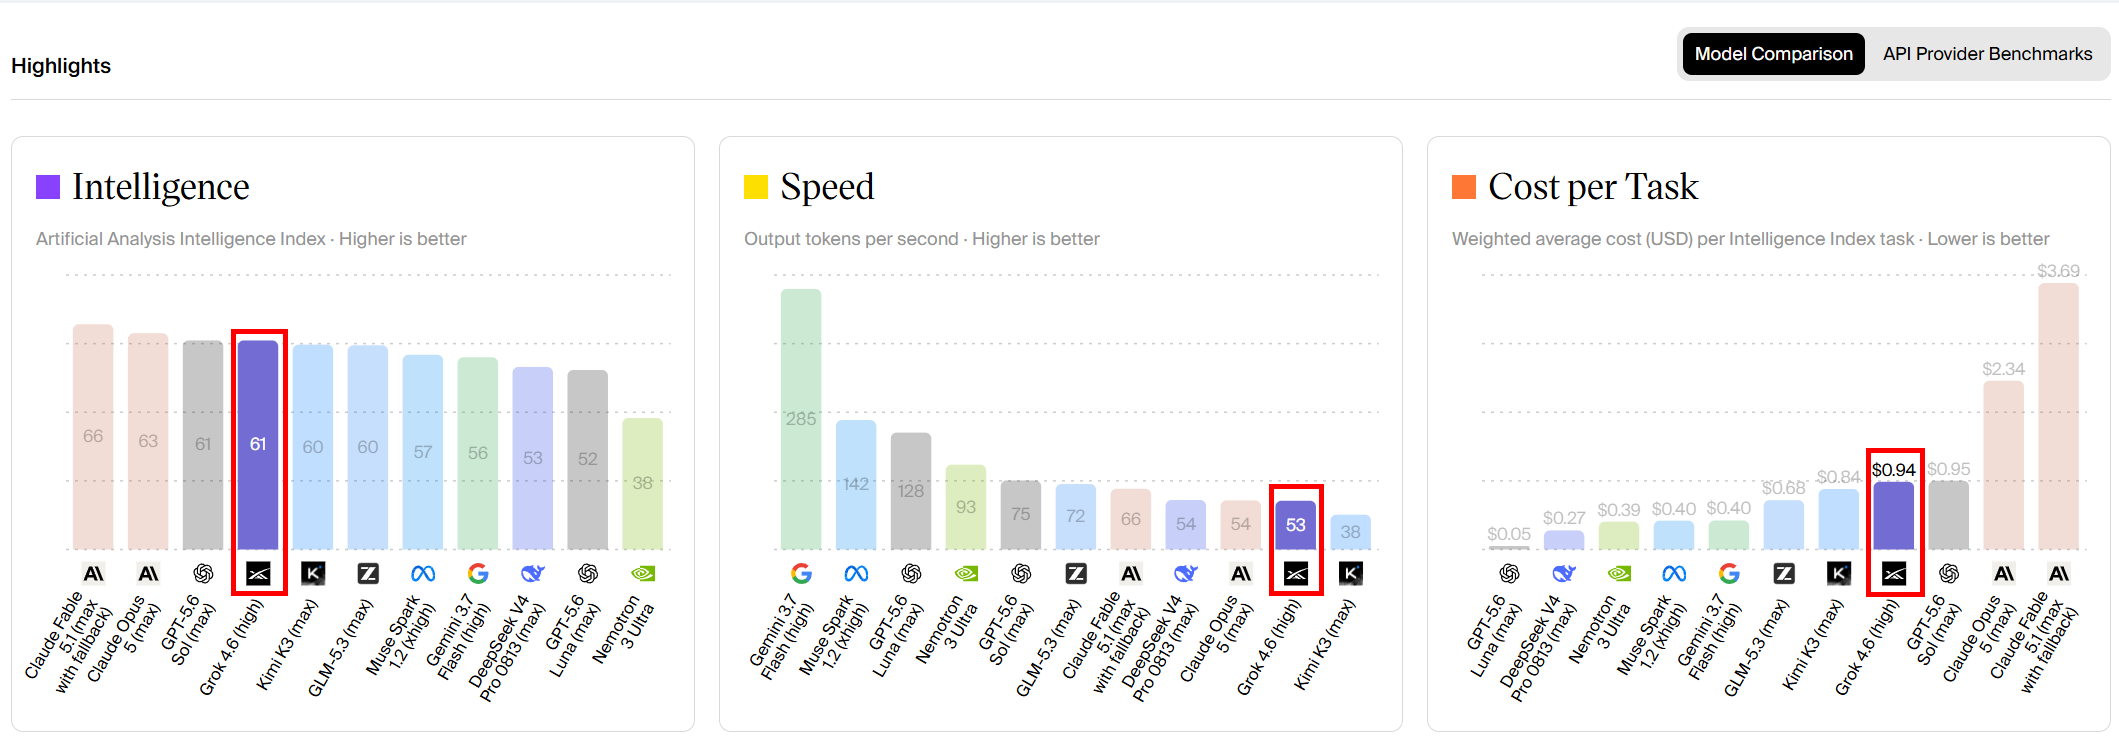
숫자부터 보겠습니다. xAI가 4.6 발표문에서 4.5 High와 4.6 High를 동일 조건으로 비교한 표입니다.
| 벤치마크 | Grok 4.5 High | Grok 4.6 High | 변화 |
|---|---|---|---|
| AA Intelligence Index | 56 | 61 | +5 |
| DeepSWE v1.1 | 54.0% | 65.9% | +11.9%p |
| APEX-Agents | 47.1% | 57.5% | +10.4%p |
| Terminal-Bench v3.0 | 15.7% | 26.0% | +10.3%p |
| CursorBench v3.2 | 66.7% | 69.9% | +3.2%p |
| FrontierCode v1.1 Extended | 56.6% | 61.3% | +4.7%p |
| APEX-SWE | 53.6% | 56.4% | +2.8%p |
| Harvey LAB | 12.9% | 15.8% | +2.9%p |
눈에 띄는 건 에이전트·장시간 작업 계열 벤치마크에서 10%p 이상 올랐다는 점입니다. DeepSWE, APEX-Agents, Terminal-Bench가 대표적이고, 단순 코딩 점수(CursorBench, APEX-SWE)는 소폭 개선에 가깝습니다.
xAI도 4.6의 방향을 “장시간 지속되는 에이전트 작업과 더 야심찬 인터랙티브·비주얼 작업”이라고 설명합니다. 한 번의 프롬프트로 끝나는 질의응답보다, 여러 단계를 거치며 코드베이스를 수정하거나 문서를 분석하는 복합 작업에서 차이가 커진 모델입니다.
컨텍스트 윈도우와 추론 설정
컨텍스트 윈도우는 500,000 토큰입니다. 4.5도 500K였으니 여기서 변화는 없습니다. “4.6이 더 긴 컨텍스트를 지원한다”는 건 사실이 아닙니다.
진짜 달라진 건 추론 단계입니다.
| 설정 | 설명 |
|---|---|
low | 최소 추론. 속도 우선 |
medium | 분석·긴 컨텍스트 작업에 적합 |
high | 깊은 추론. 기본값 |
xhigh | 최대 추론 깊이. 대신 응답이 느려짐 |
4.5는 low, medium, high까지 지원했습니다. xhigh는 4.6에서 새로 추가된 단계입니다. 4.5에 xhigh를 전달하면 high로 처리됩니다.
추론을 완전히 끄는 건 불가능합니다. reasoning_effort를 지정하지 않으면 high가 기본값으로 적용됩니다. 숫자로 된 thinking token budget(예: 16K, 32K)은 공개되지 않았고, 단계형 effort 방식만 제공됩니다.
그 외 기본 사양을 정리하면 이렇습니다.
- 입력: 텍스트 + 이미지
- 출력: 텍스트 (공식 문서상 출력 토큰 제한 없음)
- 지식 컷오프: 2026년 1월
- 지원 API: Responses API, Chat Completions
- 도구: function calling, web search, X search, code execution
코딩·에이전트 성능은 어떤가
벤치마크 수치는 위에서 봤으니, 실제로 써본 느낌을 덧붙이겠습니다.
간단한 FPS 웹 게임을 HTML로 만들어달라고 시켜봤습니다. “빠른” 모드를 선택해서 경량 모델로 돌렸는데, 꽤 잘 만들어냈습니다. 물론 간단한 작업이긴 하지만, 생각보다 사용자가 원하는 인간적인 요소를 잘 파악하고 있었습니다. xAI가 Cursor를 인수한 게 코딩 성능에 도움이 되는 것 같다는 인상을 받았습니다.
벤치마크에서 더 의미 있는 숫자는 단순 코드 생성보다 에이전트형 코딩 작업입니다. DeepSWE v1.1이 54% → 65.9%로 올랐다는 건, 실제 GitHub 이슈를 받아 코드를 수정하고 테스트를 통과시키는 능력이 눈에 띄게 좋아졌다는 뜻입니다. 한 번에 답을 내놓는 게 아니라 여러 파일을 오가며 문제를 해결하는 시나리오에서 강해진 겁니다.
그록 4.6 API 가격
API 가격은 4.5와 기본 단가가 같습니다.
| 항목 | 가격 |
|---|---|
| 입력 토큰 | $2.00 / 1M tokens |
| 캐시된 입력 토큰 | $0.50 / 1M tokens |
| 출력 토큰 | $6.00 / 1M tokens |
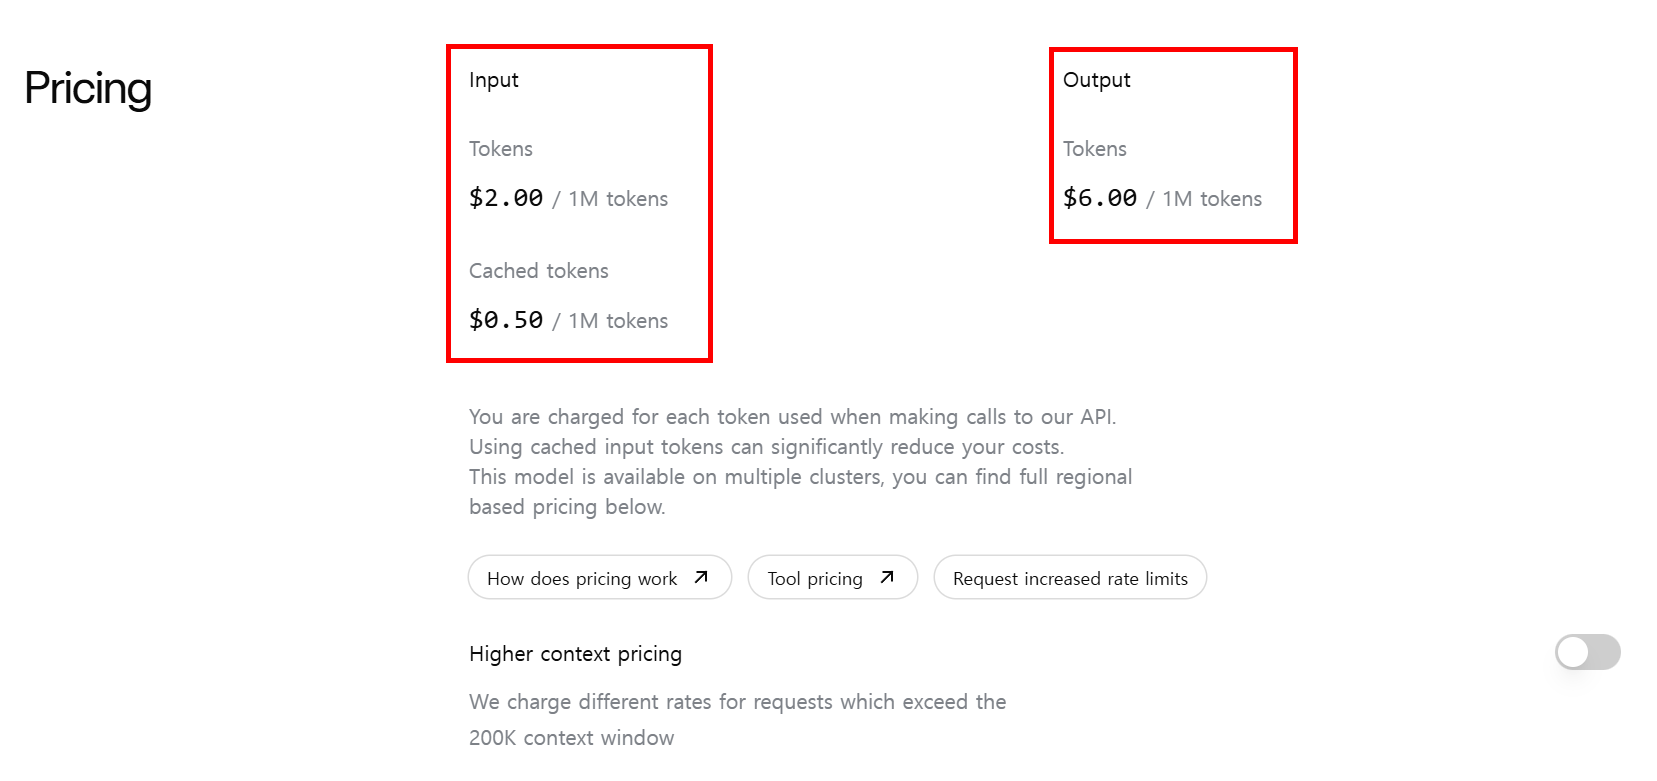
주의할 점이 하나 있습니다. 프롬프트가 200K 토큰을 넘으면 장문 컨텍스트 요금이 적용됩니다. 이 경우 입력 $4/M, 캐시 $0.60/M, 출력 $12/M으로 단가가 두 배로 뜁니다. 500K 컨텍스트를 꽉 채워 쓸 계획이라면 비용 계산을 다시 해야 합니다.
AA Intelligence Index 기준으로 작업당 평균 비용은 $0.94 수준입니다. 같은 차트에서 GPT-5.6이 $0.05, Luna가 $0.27인 걸 생각하면 저렴한 편은 아닙니다. 다만 지능 지수 61점대 모델 중에서는 경쟁력 있는 가격대입니다.
Grok에서 사용하는 방법
웹이나 앱에서 Grok을 열면 입력창 오른쪽에 모드 선택 드롭다운이 있습니다. “전문가”를 선택하면 “깊게 생각 Grok 4.6”이 활성화됩니다.
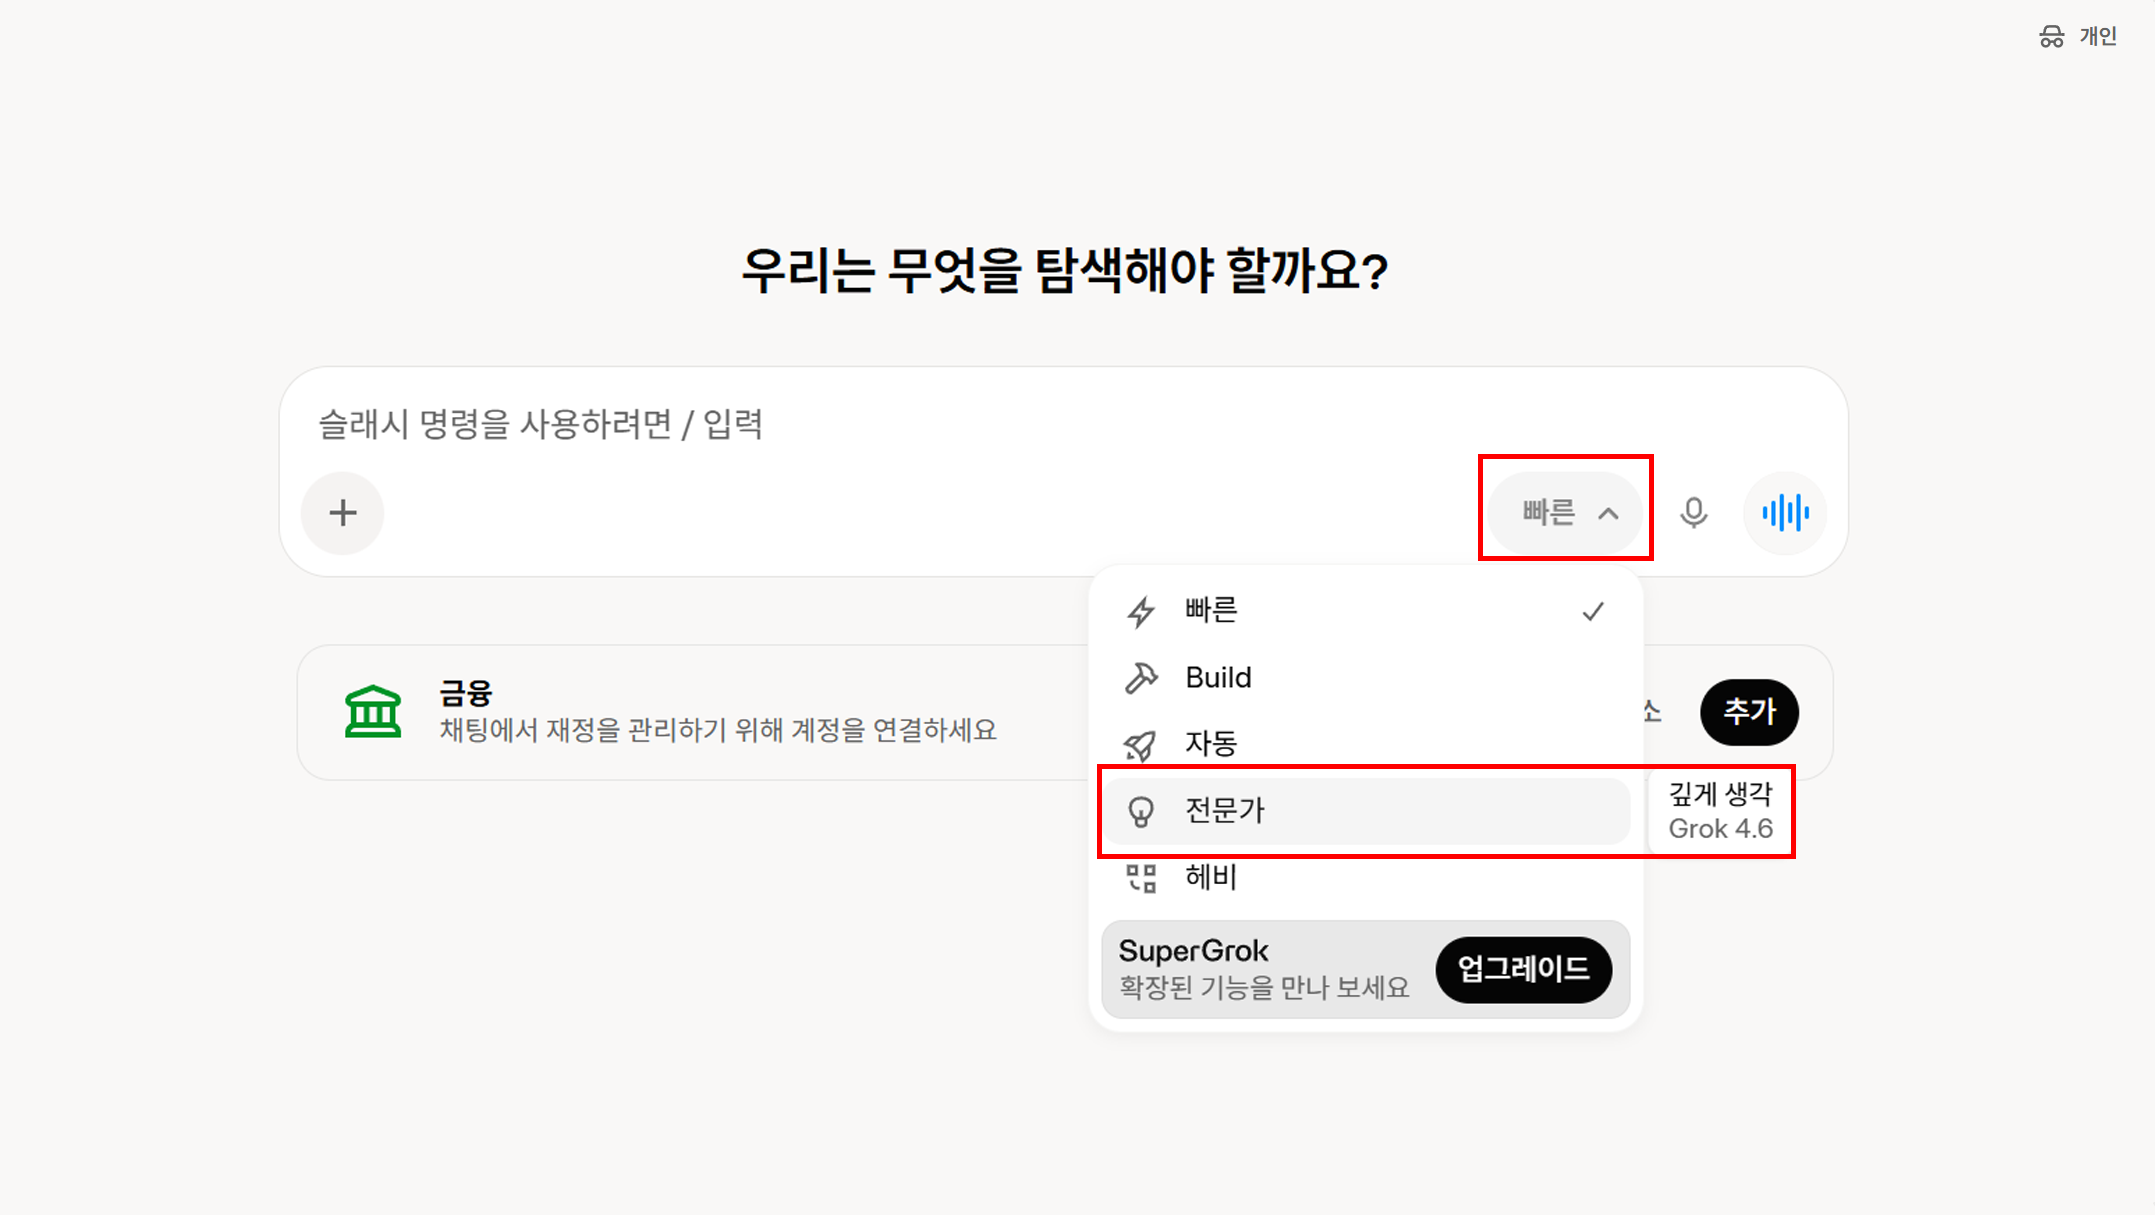
모드 목록은 빠른, Build, 자동, 전문가, 헤비로 나뉘어 있습니다. 빠른 모드는 경량 모델을 사용하고, 전문가 모드에서 Grok 4.6의 깊은 추론이 동작합니다. SuperGrok 구독 없이도 전문가 모드를 선택할 수 있지만, 사용량 제한은 구독 티어에 따라 다릅니다.
API로 직접 호출할 때는 모델 ID grok-4.6을 지정하면 됩니다. Responses API와 Chat Completions 두 가지 방식 모두 지원합니다.
이전 Grok 모델과 차이
4.5와의 상세 비교는 위에서 다뤘으니, 전체 흐름을 짧게 정리합니다.
컨텍스트와 가격은 그대로입니다. 500K 컨텍스트, 기본 $2/$6 가격 모두 4.5에서 바뀌지 않았습니다. 4.5가 2026년 7월 16일에 발표됐고 4.6이 8월 12일이니, 한 달도 안 되는 간격입니다.
바뀐 건 두 가지입니다.
- 추론 깊이: xhigh 단계 추가. 복잡한 문제에 더 많은 사고 시간을 쓸 수 있게 됐습니다.
- 에이전트·복합 작업 성능: 같은 high 설정에서도 DeepSWE +11.9%p, APEX-Agents +10.4%p, Terminal-Bench +10.3%p 향상.
단순 질의응답이나 짧은 텍스트 생성만 하는 용도라면 4.5와 체감 차이가 크지 않을 수 있습니다. 차이가 드러나는 건 여러 단계를 거치는 코드 수정, 긴 문서 분석, 에이전트 기반 자동화 작업입니다.
어떤 사용자에게 맞는가
코드베이스를 다루는 개발 작업이 많다면 4.6은 확실히 업그레이드입니다. CursorBench나 DeepSWE 점수가 말해주듯, 특히 여러 파일에 걸친 수정 작업에서 완성도가 올랐습니다.
에이전트 기반 자동화를 구축하려는 분에게도 의미가 있습니다. APEX-Agents 점수가 47.1% → 57.5%로 오른 건 도구 호출과 다단계 의사결정 능력이 개선됐다는 뜻입니다.
반면, 단순한 대화나 짧은 글쓰기가 주 용도라면 굳이 전문가 모드를 고집할 이유는 없습니다. 빠른 모드의 경량 모델도 간단한 작업은 충분히 잘 처리합니다.
정리하면 이렇습니다. 가격과 컨텍스트가 동일한 상태에서 에이전트·코딩 성능만 올린 업데이트이므로, 이미 4.5를 쓰고 있었다면 모델 ID만 바꾸면 됩니다. 새로 시작하는 분이라면 4.6부터 시작하면 됩니다.