딥시크 V4가 나왔다는 건 알겠는데, Pro랑 Flash 중 뭘 써야 하는지, 실제로 얼마나 좋아진 건지 감이 안 잡히는 분이 많습니다. V3에서 뭐가 달라졌고, 지금 바로 쓸 수 있는 건지 정리합니다.
딥시크 V4, 언제 나왔나
DeepSeek는 2026년 4월 24일 DeepSeek V4 Preview를 공개했습니다. 이후 Flash는 7월 31일 Public Beta API를, Pro는 8월 13일 GA(정식 버전)를 웹·앱·API에 배포했습니다. 2026년 9월 현재 두 모델 모두 정식으로 사용할 수 있는 상태입니다.
V4 라인업: Pro와 Flash
V4는 처음부터 두 모델로 나뉘었습니다. “Pro”는 유료 구독 플랜 이름이 아니라 모델 이름입니다. ChatGPT Plus 같은 월정액과는 다릅니다.
| 항목 | V4 Pro | V4 Flash |
|---|---|---|
| 총 파라미터 | 1.6T | 284B |
| 활성 파라미터 | 49B | 13B |
| 컨텍스트 | 1M tokens | 1M tokens |
| 최대 출력 | 384K tokens | 384K tokens |
| 포지션 | 최고 성능, 복잡한 추론·Agent | 빠른 응답, 비용 효율 |
| 웹/앱 모드 | Expert Mode | Instant Mode |
| API 동시성 한도 | 500 | 2,500 |
| 현재 버전 | V4-Pro-0813 | V4-Flash-0731 |
딥시크 V4 Pro vs Flash, 실제로 뭐가 다른가
기능 목록만 보면 차이가 거의 없습니다. 둘 다 Thinking/Non-thinking 추론을 지원하고, reasoning effort도 low·high·max 세 단계를 똑같이 제공합니다. Tool Calls, JSON Output, Responses API 전부 동일합니다.
차이는 모델 크기에서 옵니다. Pro는 토큰당 49B 파라미터를 활성화하고, Flash는 13B만 활성화합니다. 같은 질문에도 Pro가 더 깊이 있는 답을 내는 경향이 있고, 특히 복잡한 Agent 작업이나 고난도 코딩에서 격차가 벌어집니다.
반대로 Flash는 활성 파라미터가 적은 만큼 응답이 빠르고 API 비용이 낮습니다. DeepSeek도 Flash를 “smaller parameter size, faster response times, and highly cost-effective”로 소개합니다. 단, 공식적으로 “몇 배 빠르다”는 수치는 발표된 적이 없으니 속도 차이를 숫자로 단정하긴 어렵습니다.
V3에서 뭐가 바뀌었나: 1M 컨텍스트와 추론
가장 큰 변화는 컨텍스트 길이입니다.
| V3.2 | V4 Pro | V4 Flash | |
|---|---|---|---|
| 컨텍스트 | 128K | 1M | 1M |
| 총 파라미터 | 671B | 1.6T | 284B |
| 활성 파라미터 | 37B | 49B | 13B |
128K에서 100만 토큰으로, 약 7.8배 늘었습니다. 긴 문서 전체를 한 번에 넣고 분석하는 작업이 현실적으로 가능해진 겁니다.
추론 모드도 정리됐습니다. 이전에는 Deep Think 온/오프 정도였지만, V4에서는 Non-think / Think High / Think Max 세 단계로 세분화됐습니다. 간단한 질문에는 Non-think, 일상적인 작업에는 High, 어려운 문제에는 Max를 선택할 수 있습니다.
Agent 기능도 강화됐습니다. Claude Code, OpenClaw, OpenCode 같은 에이전트 환경에 최적화됐고, Agentic Coding 벤치마크에서 오픈소스 최고 성능을 기록했습니다.
딥시크 V4 성능, 벤치마크로 보면
V4의 공식 벤치마크는 두 종류로 나눠서 봐야 합니다. Base 모델 비교와 Instruct 모델의 프런티어 비교는 평가 조건이 다릅니다.
Base 모델: V3.2 대비 얼마나 올랐나
| 벤치마크 | V3.2 Base | V4 Flash Base | V4 Pro Base |
|---|---|---|---|
| MMLU (5-shot) | 87.8 | 88.7 | 90.1 |
| HumanEval (0-shot) | 62.8 | 69.5 | 76.8 |
| MATH (4-shot) | 60.5 | 57.4 | 64.5 |
| LongBench-V2 | 40.2 | 44.7 | 51.5 |
Pro Base는 MMLU 90.1, HumanEval 76.8을 기록했습니다. 다만 Flash가 모든 항목에서 V3.2를 이긴 건 아닙니다. MATH에서는 V3.2(60.5)가 Flash(57.4)보다 높고, BigCodeBench도 V3.2가 앞섭니다. “V4면 무조건 좋다”는 아닌 셈입니다.
Instruct 모델: GPT·Claude·Gemini와 비교
V4-Pro-Max는 GPT-5.4, Claude Opus 4.6, Gemini 3.1 Pro 같은 당대 프런티어 모델과 비교됐습니다.
코딩 벤치마크(LiveCodeBench 93.5, Codeforces 3206)에서는 경쟁 모델을 앞섰고, 수학(IMOAnswerBench 89.8)에서도 강했습니다. 반면 일부 지식·추론 벤치마크에서는 Gemini나 GPT에 뒤지는 항목도 있습니다. 모든 영역에서 1등은 아니지만, 오픈소스 모델로서는 프런티어급에 진입한 성적입니다.
실제 사용법: Expert와 Instant
DeepSeek 웹사이트나 앱에서는 별도 설치 없이 바로 V4를 쓸 수 있습니다.
- Expert Mode: V4 Pro가 작동합니다. 복잡한 질문, 긴 문서 분석, 코드 작업에 적합합니다.
- Instant Mode: V4 Flash가 작동합니다. 빠른 답변이 필요한 일상적인 질문에 맞습니다.
하단의 “깊은 생각” 버튼을 누르면 Thinking 모드가 활성화됩니다. 검색 기능도 함께 제공됩니다.
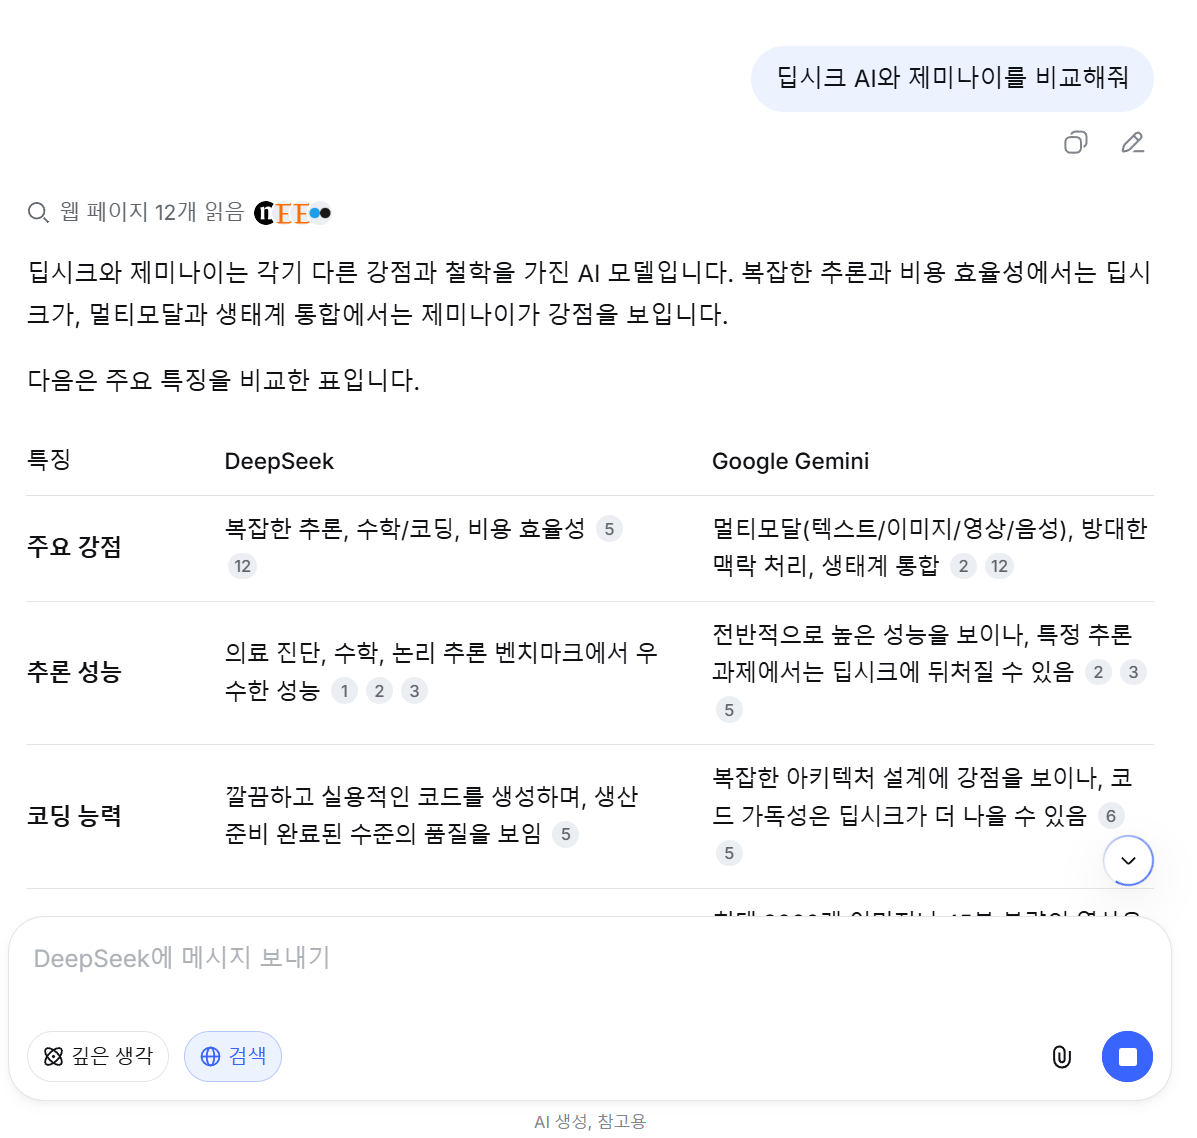
한 가지 재밌는 경험이 있었는데, 깊은 생각 모드를 켜고 질문을 했더니 사고 과정(Chain of Thought)이 중국어로 쫙 펼쳐진 뒤 답변까지 중국어로 나온 적이 있습니다. DeepSeek가 중국 회사다 보니 내부 추론 언어가 중국어로 작동하는 경우가 있는 겁니다. 당황스럽지만 인상적인 장면이었습니다.
딥시크 V4 가격: API는 종량제
웹과 앱은 무료로 이용할 수 있습니다. API는 별도의 월 구독이 아니라 사용한 토큰만큼 과금하는 종량제입니다.
2026년 8월 16일부터 피크/오프피크 요금이 적용됩니다. 100만 토큰 기준 가격입니다.
| 모델 | 구분 | 입력(캐시 미적중) | 출력 |
|---|---|---|---|
| V4 Flash | 오프피크 | $0.22 | $0.66 |
| V4 Flash | 피크 | $0.44 | $1.32 |
| V4 Pro | 오프피크 | $0.66 | $1.98 |
| V4 Pro | 피크 | $1.32 | $3.96 |
피크 시간은 한국시간 기준 평일 10:00~13:00, 15:00~19:00입니다. 그 외 시간과 주말은 오프피크로, 비용이 정확히 절반입니다. 대량 API 작업이라면 오프피크에 돌리는 것만으로 비용을 크게 줄일 수 있습니다.
캐시에 적중하는 반복 입력은 훨씬 저렴합니다. Flash 오프피크 기준 캐시 적중 입력은 $0.007로, 캐시 미적중 대비 약 1/30 수준입니다.
API 연동
API 모델 ID는 deepseek-v4-flash와 deepseek-v4-pro입니다. OpenAI 형식 API의 Base URL은 https://api.deepseek.com이고, Anthropic 호환 형식은 https://api.deepseek.com/anthropic입니다. Tool Calls, Responses API, JSON Output 모두 지원합니다.
별도로 deepseek-v4-flash-vision-exp라는 이미지 입력용 실험 모델도 있습니다. 일반 Pro와 Flash에서는 이미지 입력이 되지 않습니다.
Pro를 쓸까, Flash를 쓸까
Flash가 맞는 경우: 일상적인 질문, 간단한 요약, 단순한 코드 생성, API로 대량 처리할 때. 비용과 속도가 중요하다면 Flash부터 시작하는 게 합리적입니다.
Pro가 맞는 경우: 복잡한 추론이 필요한 작업, 긴 문서 전체를 정밀 분석할 때, Agent 기반 코딩 작업, 벤치마크 수준의 정확도가 필요할 때. Expert Mode로 먼저 써보고 차이를 체감한 뒤 API로 넘어가는 순서가 자연스럽습니다.
대부분의 일반 사용에서는 Flash로 충분합니다. Pro는 “Flash로 해봤는데 답이 아쉽다” 싶을 때 올리면 됩니다.
V3에서 V4로, 실제로 세대교체인가
정리하면 V4의 핵심 변화는 세 가지입니다. 컨텍스트가 128K에서 100만 토큰으로 늘었고, 추론 단계를 세밀하게 조절할 수 있게 됐으며, Agent 환경에 본격적으로 최적화됐습니다. 벤치마크에서 프런티어 폐쇄형 모델과 경쟁하는 수준이 됐다는 점도 의미 있습니다.
다만 Flash가 V3.2보다 모든 벤치마크에서 우위인 건 아니고, 공식 속도 비교 수치도 아직 없습니다. “V4니까 무조건 좋다”보다는, 자기 작업에 맞는 모델을 골라 쓰는 게 V4를 제대로 쓰는 방법입니다.