Qwen 한국어, 과연 쓸 만할까? 알리바바의 오픈소스 AI 모델 Qwen은 공식적으로 한국어를 지원한다고 밝히고 있습니다. 그런데 “지원한다”는 것과 “잘한다”는 건 전혀 다른 이야기입니다. 직접 써보고, 공개된 평가 데이터도 함께 확인해 봤습니다.
Qwen은 한국어를 어떻게 지원하나
Qwen의 한국어 지원은 “한국어 전용 모델”이 아니라, 다국어 학습 범위에 한국어를 포함시키는 방식입니다.
| 모델 계열 | 지원 언어 수 | 한국어 포함 | 한국어 학습 비중 |
|---|---|---|---|
| Qwen2.5 | 29개 이상 | 명시 | 미공개 |
| Qwen3 | 119개 언어·방언 | 명시 | 미공개 |
| Qwen3.5 | 201개 언어·방언 | 명시 | 미공개 |
공통점이 보이시나요? 한국어가 목록에는 들어가 있지만, 한국어 데이터를 얼마나 학습했는지는 어디에도 공개되지 않았습니다. Qwen2.5는 총 18조 토큰, Qwen3는 36조 토큰을 학습했다고 밝혔을 뿐, 그중 한국어가 몇 퍼센트인지는 알 수 없습니다.
그래도 Qwen2.5는 한국어 전용 벤치마크(KMMLU)를 공식 보고서에 포함시킨 유일한 버전입니다. 최소한 한국어 성능을 의식하고 있다는 뜻이긴 합니다.
실제 사용 환경
아래는 qwen3.6-35b 모델에 한국어로 말을 걸었을 때의 화면입니다.
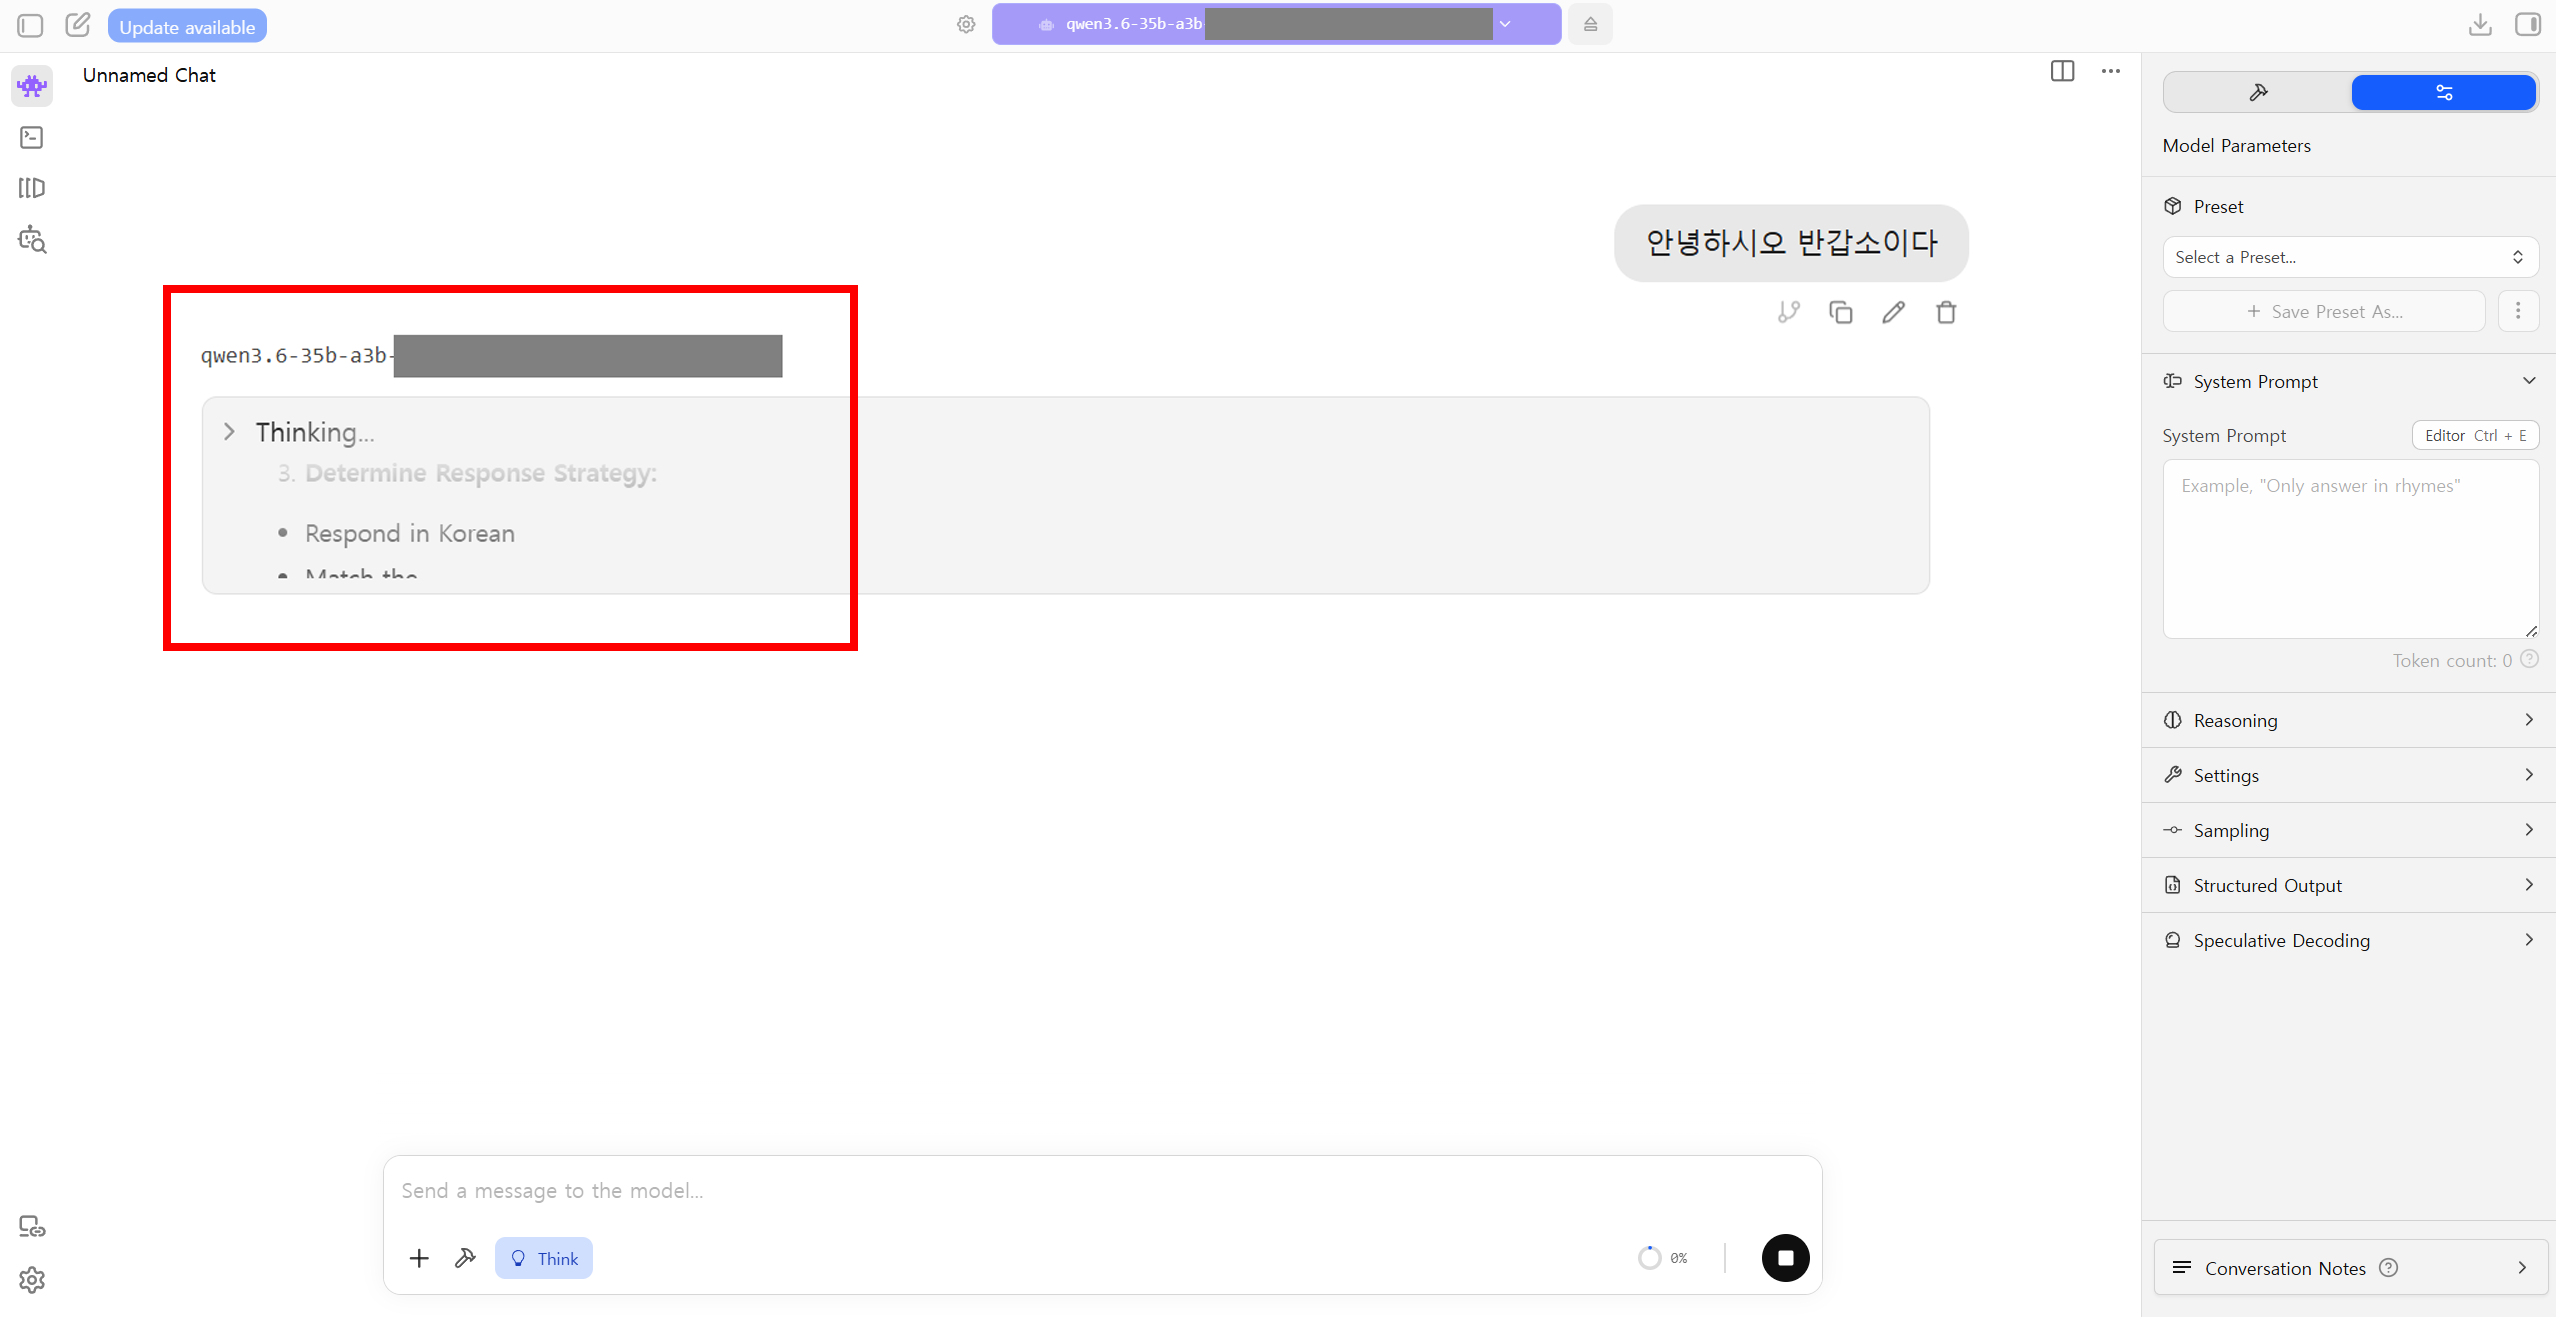
Thinking 과정을 보면 “Respond in Korean”이라는 전략을 스스로 세우는 걸 확인할 수 있습니다. 한국어로 질문하면 한국어로 답하려고 시도하긴 합니다. 문제는 그 한국어의 품질입니다.
Qwen 한국어 성능, 어디가 괜찮고 어디가 부족한가
지식형 질문: 꽤 쓸 만하다
한국어로 된 전문지식 객관식 평가(KMMLU)에서 Qwen2.5-72B는 61.96%를 기록했습니다. 같은 조건의 Llama 3.1-70B(53.23%)보다 확실히 높고, GPT-4o-mini(56.77%)도 넘습니다.
한국어 수학 문제(HRM8K)에서도 Qwen2.5-72B는 GPT-4o와 평균 1점 차이로 거의 동등한 결과를 보여줬습니다. 한국 학교수학(KSM) 항목에서는 오히려 근소하게 앞서기도 했습니다.
| 모델 | HRM8K 평균 | 한국 학교수학(KSM) |
|---|---|---|
| GPT-4o | 57.59 | 22.83 |
| Qwen2.5-72B | 56.63 | 23.46 |
| Llama 3.1-70B | 45.61 | 13.10 |
요약하면, 한국어로 된 객관식 문제나 지식 검색형 질문에는 오픈소스 모델 중 상위권입니다.
한국어 감각: 여기서 차이가 드러난다
숫자만 보면 괜찮아 보이지만, 실제로 한국어의 뉘앙스를 다루는 능력은 다릅니다.
서울대 KoBALT 평가는 한국어 문법·의미·화용·형태·음운을 직접 묻습니다. 여기서 결과가 확 달라집니다.
| 모델 | 평균 | 의미 | 형태 | 음운 |
|---|---|---|---|---|
| Claude 3.5 Sonnet | 52 | 65 | 36 | 24 |
| GPT-4o | 44 | 55 | 17 | 26 |
| Qwen2.5-72B | 37 | 51 | 24 | 18 |
| Llama 3.3-70B | 32 | 50 | 17 | 15 |
Qwen2.5-72B는 오픈 모델 중에서는 가장 높지만, GPT-4o보다 7점, Claude보다 15점 낮습니다. 특히 형태론이나 음운론처럼 한국어 고유의 미세한 규칙을 묻는 영역에서는 모든 모델이 낮긴 하지만, Qwen의 점수는 더 떨어집니다.
이 차이가 실제 대화에서 어떻게 느껴지는지, 한 가지 예를 보겠습니다.
직접 써보니: 한국어 “감”이 빠져 있다
Qwen에게 한국어 말장난을 시켜봤습니다.
질문: 재미있는 한국어 농담 하나만 해줘
Qwen: 피자 배달부가 길을 가다가 넘어지면 뭐가 될까요? 정답은… ‘피자 도우'(도우미)입니다!
솔직히 이게 왜 웃긴 건지 모르겠습니다. “피자 도우”와 “도우미”를 연결하려는 시도인 것 같은데, 한국어 말장난의 기본 구조인 동음이의어 활용이 제대로 작동하지 않습니다. 말은 한국어로 하고 있지만, 한국어의 언어 감각은 부족한 상태입니다.
같은 유형의 질문을 Gemini에게 던져보면 차이가 느껴집니다.
Gemini: 왕이 넘어지면? 킹콩.
최소한 “킹(King)”과 “콩(쿵)”의 소리 연결이 성립합니다. 완성도 높은 개그는 아니지만, 적어도 한국어 말장난이 뭔지는 알고 있다는 느낌입니다. Qwen의 결과물은 그 수준에도 미치지 못했습니다.
다른 AI와 비교하면
벤치마크별로 정리하면 이런 그림이 나옵니다.
Qwen이 강한 영역:
- 한국어 전문지식(KMMLU): 오픈 모델 중 최상위, GPT-4o-mini보다 높음
- 한국어 수학(HRM8K): GPT-4o와 거의 동등
Qwen이 약한 영역:
- 한국어 언어 감각(KoBALT): GPT-4o, Claude보다 뒤처짐
- 한국 문화 맥락 추론(HRMCR): GPT-4o 대비 18점 낮음
한 가지 주의할 점은, 위 벤치마크 대부분이 객관식 이해·추론 평가라는 겁니다. 번역 품질이나 자연스러운 장문 글쓰기를 직접 수치화한 공개 비교 데이터는 아직 없습니다. 따라서 “Qwen 번역이 GPT보다 좋다/나쁘다”를 숫자로 단정할 근거는 부족합니다.
한국어 사용자에게 쓸 만한가
정리하면 이렇습니다.
쓸 만한 경우:
- 한국어로 질문하고 정보를 얻는 일반적인 대화
- 한국어 텍스트 요약, 간단한 초안 작성
- 객관식 문제 풀이나 지식 검색형 작업
- 오픈소스 모델이 필요한 환경에서 Llama 대신 선택
주의가 필요한 경우:
- 한국어 뉘앙스가 중요한 글쓰기(카피라이팅, 말장난, 감성적 표현)
- 한국 문화·제도·관습에 대한 맥락 판단
- 법률·의료·교육 평가처럼 정밀한 한국어 이해가 필요한 작업
- 한국어 표현의 교정이나 문법 검수
Qwen은 한국어를 “할 줄 아는” 모델입니다. 다만 한국어를 “잘 아는” 모델이라고 하기엔 아직 거리가 있습니다. 오픈소스 모델 중에서는 확실히 좋은 선택지이지만, GPT-4o나 Claude 수준의 한국어 감각을 기대하면 실망할 수 있습니다. 특히 한국어의 미묘한 표현이 중요한 작업이라면, 결과물을 반드시 사람이 확인하는 과정이 필요합니다.