Qwen을 LM Studio에서 로컬로 돌려보고 싶은데, 어디서부터 시작해야 할지 모르겠다면 이 글이 맞습니다. 다운로드부터 설정, 실행, 체감 성능까지 한 번에 정리합니다.
준비 사항: 내 PC에서 돌릴 수 있을까?
LM Studio를 설치하기 전에 먼저 확인할 것은 운영체제와 메모리입니다.
지원 운영체제:
- macOS: Apple Silicon(M1~M4), macOS 14.0 이상. Intel Mac은 지원하지 않습니다.
- Windows: x64(AVX2 필요) 및 ARM(Snapdragon X Elite).
- Linux: x64 및 ARM64, Ubuntu 20.04 이상. AppImage와 .deb 패키지로 제공됩니다.
메모리 기준:
공식 권장은 RAM 16GB 이상, Windows의 경우 GPU VRAM 4GB 이상입니다. 다만 이건 “LM Studio를 실행할 수 있는 최소치”에 가깝고, 실제로 어떤 모델을 돌리느냐에 따라 필요 메모리가 크게 달라집니다. 뒤에서 모델별 권장 RAM을 따로 정리합니다.
LM Studio 최신 안정 버전은 0.4.24이며, 공식 사이트(lmstudio.ai)에서 OS에 맞는 설치 파일을 받으면 됩니다.
Qwen LM Studio에서 모델 검색하고 선택하기
설치가 끝나면 왼쪽 메뉴에서 Discover(돋보기 아이콘)를 누르고 검색창에 qwen을 입력합니다.
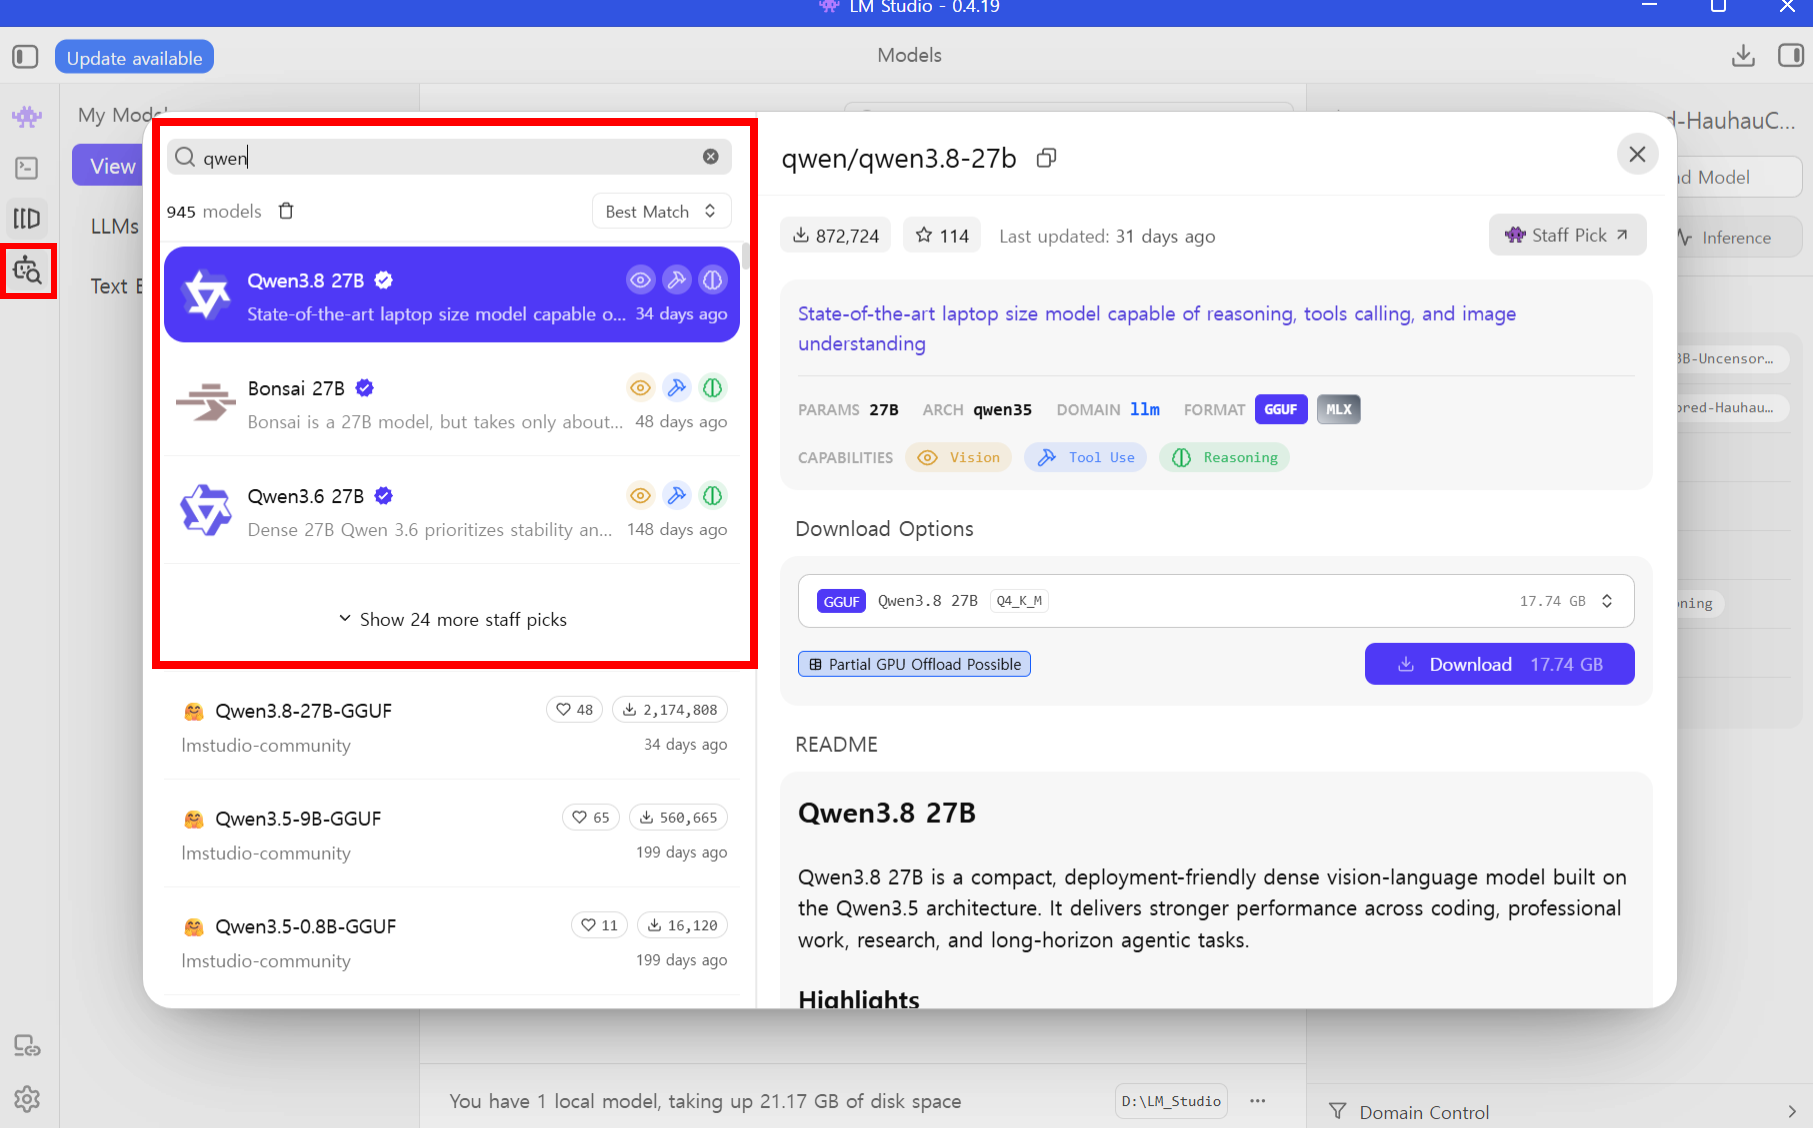
검색 결과가 꽤 많이 나옵니다. Staff Pick으로 추천되는 모델이 상단에 뜨고, 그 아래로 커뮤니티가 양자화한 GGUF 파일들이 쭉 나열됩니다. 여기서 중요한 건 모델 크기와 내 시스템 메모리의 관계입니다.
어떤 크기를 골라야 하나
| 모델 | 파라미터 | Q4_K_M 파일 크기 | 권장 RAM |
|---|---|---|---|
| Qwen3-4B | 4B | 2.5GB | 12GB |
| Qwen3-8B | 8B | 5GB | 16GB |
| Qwen3-14B | 14B | 9GB | 24GB |
| Qwen3-30B-A3B (MoE) | 30.5B (활성 3.3B) | 18.6GB | 32GB |
| Qwen3-32B | 32.8B | 19.8GB | 32GB |
| Qwen2.5-7B-Instruct | 7B | — | 16GB |
| Qwen2.5-14B-Instruct | 14B | — | 24GB |
표의 권장 RAM은 Q4 양자화 기준으로 모델 가중치 + OS + LM Studio + 4K~8K 컨텍스트를 감안한 보수적 수치입니다. 긴 문서를 붙여넣거나 컨텍스트를 32K까지 늘리면 더 필요합니다.
RAM이 16GB라면 Qwen3-8B, 32GB 이상이면 Qwen3-30B-A3B나 Qwen3-32B를 시도해볼 수 있습니다. 처음이라면 Qwen3-8B Q4_K_M부터 시작하는 게 무난합니다.
양자화는 뭘 고르나
- Q4_K_M: 용량·속도·품질 균형점. 첫 선택으로 적합합니다.
- Q5_K_M / Q6_K: 메모리 여유가 있으면 품질을 조금 더 보존합니다.
- Q8_0: 원본에 가깝지만 메모리 요구량이 크게 올라갑니다.
- Q2_K / Q3_K_M: 저사양 전용. 품질 손실이 체감될 수 있습니다.
다운로드
모델을 선택하면 오른쪽에 Download Options가 나타납니다. 원하는 양자화 버전을 골라 Download 버튼을 누르면 끝입니다. 파일 크기가 크니 시간이 좀 걸릴 수 있습니다. 하단 상태 바에서 다운로드 진행 상황을 확인할 수 있습니다.
모델 포맷은 두 가지입니다:
- GGUF: macOS, Windows, Linux 모두에서 llama.cpp 런타임으로 실행. 범용 선택지입니다.
- MLX: Apple Silicon Mac 전용. M시리즈 칩의 통합 메모리를 효율적으로 활용합니다.
Windows나 Linux 사용자는 GGUF를 선택하면 됩니다.
LM Studio 설정: Qwen에 맞는 값 잡기
모델을 로드하기 전에 몇 가지 설정을 잡아주면 응답 품질이 달라집니다. Chat 화면 오른쪽의 Model Parameters 패널에서 조정할 수 있습니다.
GPU Offload
VRAM이 충분하면 Max(가능한 모든 레이어)로 설정합니다. GPU에 많이 올릴수록 빠릅니다. 메모리 경고가 뜨면 자동값으로 돌아가거나 조금씩 낮춥니다.
Context Length
LM Studio 기본값은 8,192 토큰(8K)입니다. 일반 대화에는 이 정도면 충분합니다. Qwen3 모델의 네이티브 컨텍스트는 32K이므로, 긴 문서를 붙여넣고 요약하는 식의 작업에는 메모리 여유가 있을 때 32K까지 올릴 수 있습니다.
Temperature와 샘플링
Qwen 공식 권장값이 모델 세대에 따라 다릅니다:
| 설정 | Qwen2.5 Instruct | Qwen3 일반(비사고) | Qwen3 추론(사고) |
|---|---|---|---|
| Temperature | 0.7 | 0.7 | 0.6 |
| Top P | 0.8 | 0.8 | 0.95 |
| Top K | 20 | 20 | 20 |
| 반복 억제 | Repeat penalty 1.05 | Presence penalty 1.5 | Presence penalty 1.5 |
Qwen3 사고 모드에서는 Temperature를 0으로 내리지 않는 것이 권장됩니다. Greedy decoding이 오히려 품질을 떨어뜨릴 수 있기 때문입니다.
실행: 실제로 대화해보기
설정을 마쳤으면 Chat 탭에서 모델을 로드하고 메시지를 보내면 됩니다.
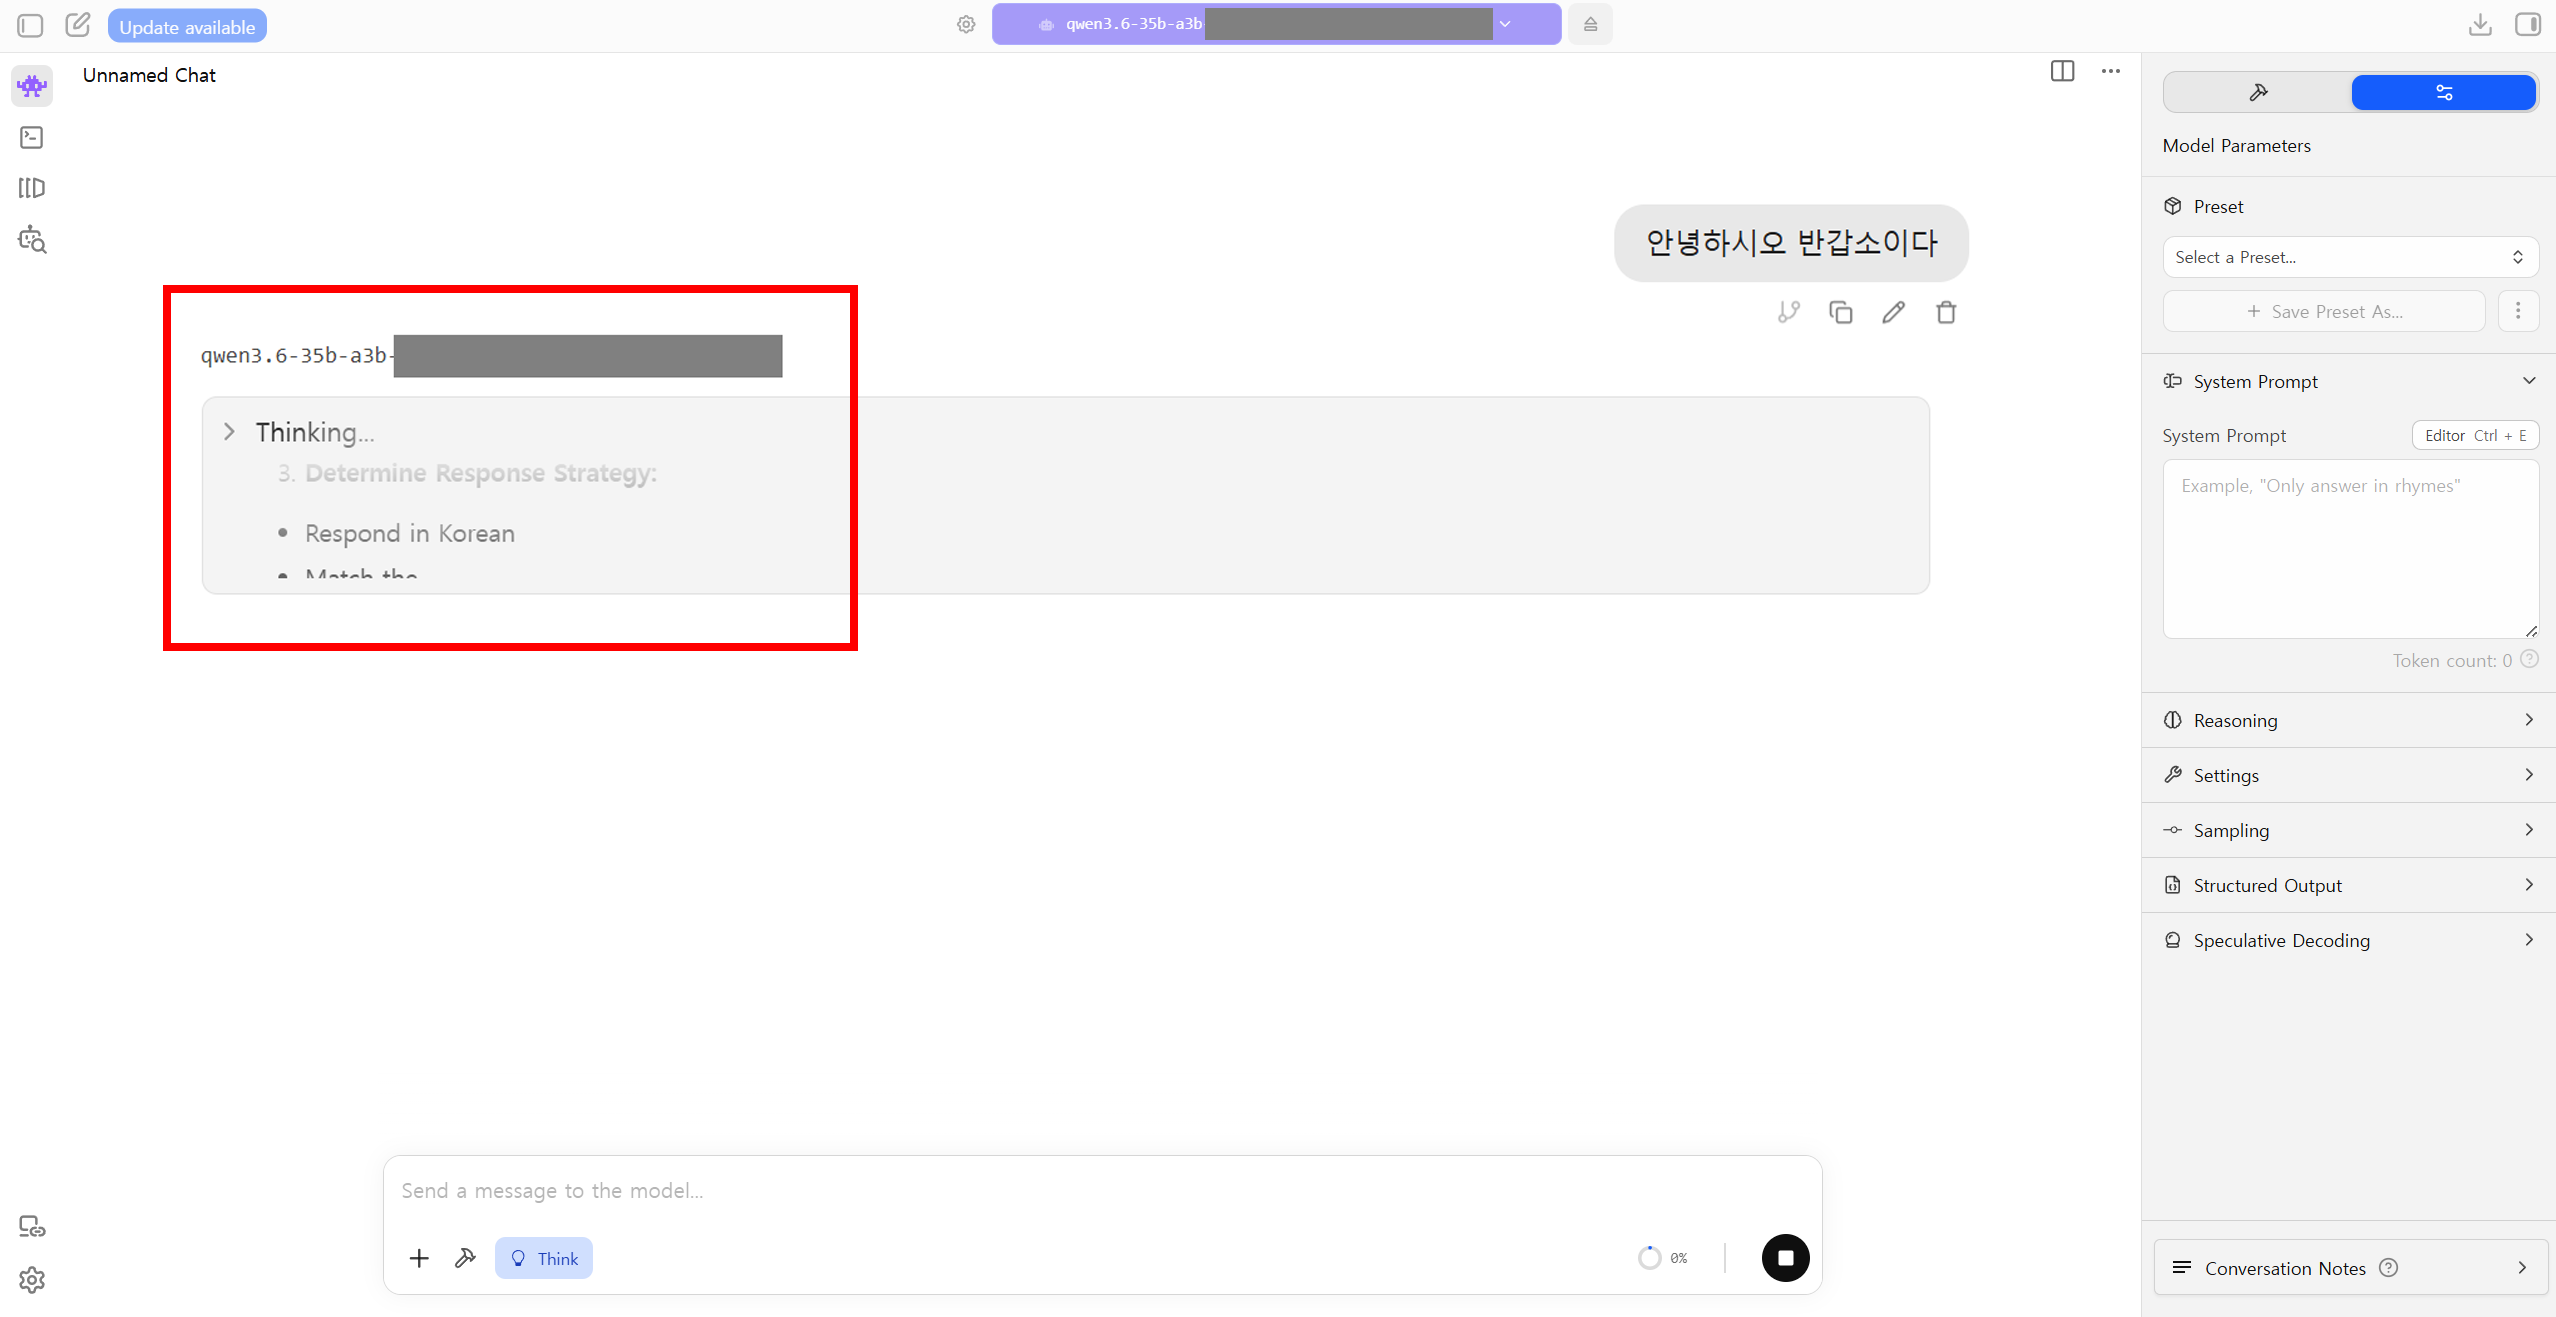
위 화면처럼 Qwen3 모델이 “Thinking…” 상태를 거치며 응답을 생성합니다. 사고 모드가 켜져 있으면 추론 과정이 접힌 상태로 표시되고, 그 아래에 최종 답변이 나옵니다. 한국어 질문에도 한국어로 응답합니다.
로컬 API 서버로 쓰고 싶다면 기본 주소는 http://localhost:1234입니다. Developer 탭에서 서버를 켜면 다른 앱에서 OpenAI 호환 API로 Qwen을 호출할 수 있습니다.
실사용 체감: 4060 랩톱에서 써본 느낌
RTX 4060 랩톱(RAM 약 36GB)에서 직접 돌려본 결과, 일반 챗봇 용도로는 나쁘지 않은 수준이었습니다. 다만 생각보다 느리다는 게 솔직한 체감입니다. 4090이나 Mac Studio 같은 고사양이 아니다 보니 응답 생성에 시간이 걸립니다.
GPT 5.6 Sol이 나온 시점 기준으로, 로컬 모델을 에이전트처럼 복잡한 작업에 쓰기에는 성능 역체감이 있었습니다. 반면 검열 없이 부담 없는 질문을 던지기에는 로컬 모델만의 장점이 확실합니다. 사회적으로 민감한 주제나 창작물 관련 질문처럼 클라우드 서비스에서 거절당하기 쉬운 요청을 자유롭게 시도할 수 있다는 점이 로컬 실행의 가장 실질적인 이점입니다.
자주 막히는 지점과 최적화 팁
모델 로드가 안 되거나 멈출 때:
- 메모리 부족이 가장 흔한 원인입니다. 더 작은 모델이나 더 낮은 양자화(Q4 → Q3)를 시도합니다.
- Context Length를 줄이면 메모리 사용량이 바로 줄어듭니다. 32K에서 8K로만 내려도 차이가 큽니다.
응답이 너무 느릴 때:
- GPU Offload가 제대로 걸려 있는지 확인합니다. CPU만으로 돌리면 속도가 몇 배 느려집니다.
- 불필요하게 긴 컨텍스트는 줄입니다. 컨텍스트가 길수록 매 토큰 생성이 느려집니다.
응답 품질이 이상할 때:
- Temperature가 너무 높으면 횡설수설하고, 너무 낮으면 반복합니다. Qwen 권장값(0.6~0.7)에서 시작해 조절합니다.
- Q2 같은 극단적 양자화는 품질 손실이 눈에 띕니다. 가능하면 Q4_K_M 이상을 사용합니다.
32K 넘는 컨텍스트가 필요할 때:
Qwen은 네이티브 32K를 넘기려면 YaRN/RoPE 스케일링이 필요하다고 안내합니다. LM Studio에서 단순히 숫자를 올린다고 성능이 보장되지는 않으므로, 장문이 꼭 필요하다면 Qwen2.5-7B-Instruct-1M 같은 전용 장문 모델을 찾아보는 편이 낫습니다.
정리하면, Qwen LM Studio 사용법의 핵심은 내 하드웨어에 맞는 모델 크기 선택과 Qwen 공식 권장 설정값 적용 두 가지입니다. 이 두 가지만 잡으면 설치 후 10분 안에 로컬 AI 챗봇을 돌릴 수 있습니다.